News World
Les sorties
Les modèles, les API et les produits parus, avec ce qu'ils font, ce qu'ils ne font pas, et le lien vers l'annonce d'origine.
Rien pour cette recherche dans les numéros parus.
Les sorties
Numéro 009 · deepseek v4.1 flash revient, sous licence mit
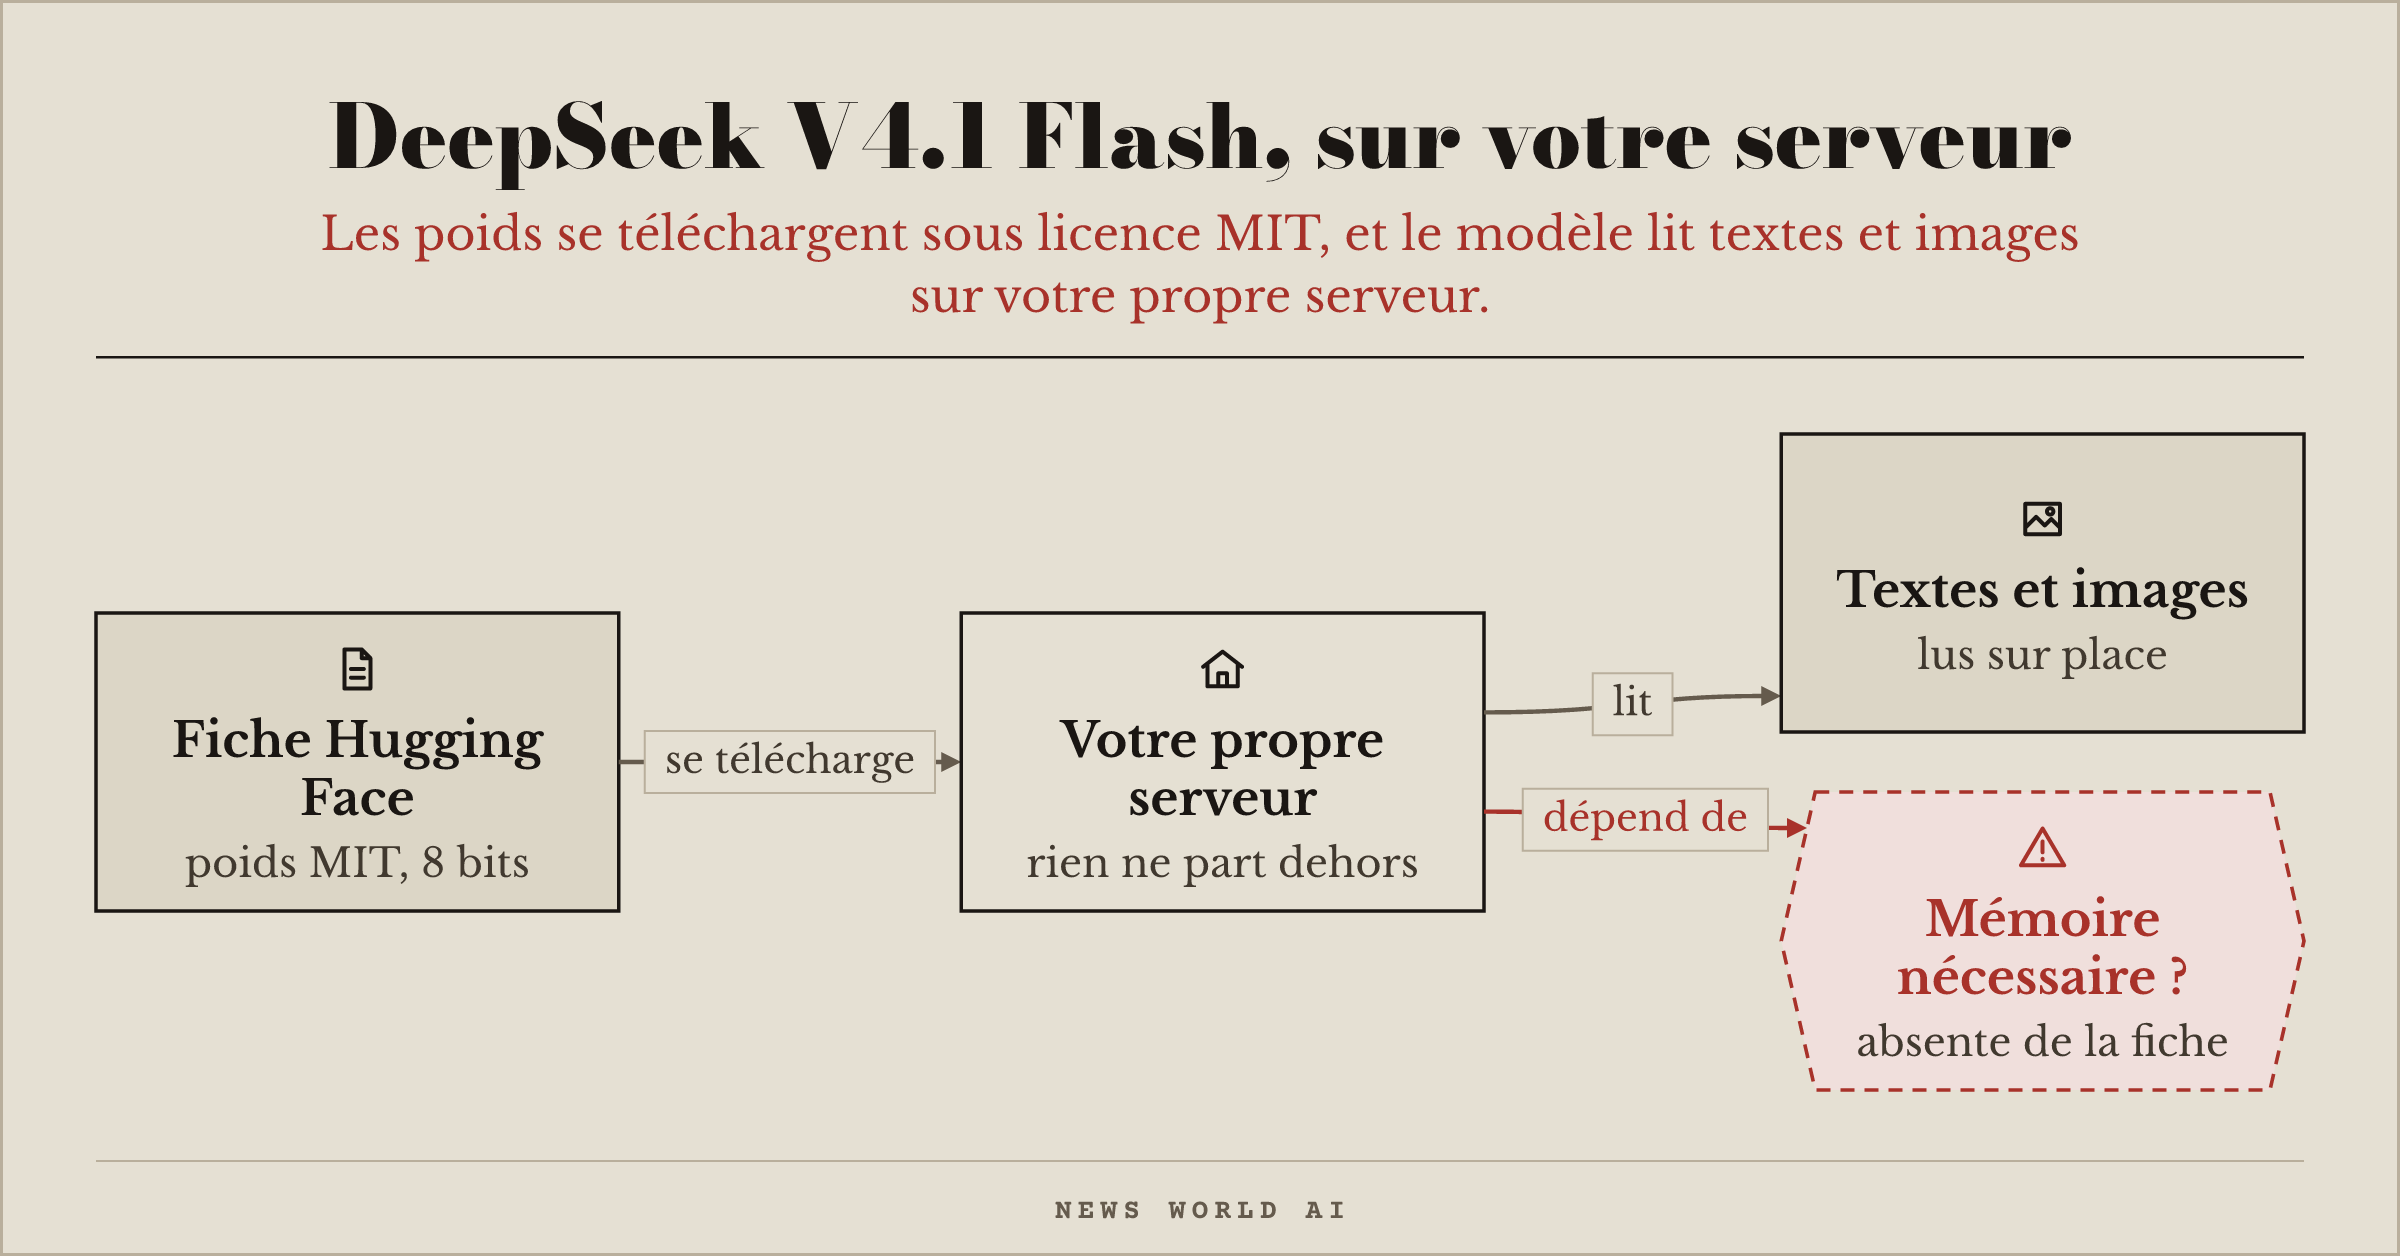
DeepSeek V4.1 Flash 1017 (DeepSeek)
27 737 téléchargements, 1 876 mentions j'aime sur Hugging Face. Licence MIT.
Pour quoi faire Faire tourner sur votre propre serveur un modèle rapide de 763 milliards de paramètres qui lit aussi les images, sans rien envoyer à DeepSeek. Les poids (le fichier du modèle) se téléchargent en version allégée sur 8 bits, selon leurs étiquettes, et la licence MIT ne vous impose presque rien. DeepSeek la présente comme une mise à jour mineure de la version du 004 : raisonnement, code, tâches d'agent et images progressent (42,6 contre 36,8 au test HLE sans outils). Mise en ligne le 17 octobre sur Hugging Face, elle sort la semaine où un ordre du ministère américain de la Sécurité intérieure, publié le 20 octobre au Federal Register, retire des agences fédérales civiles les produits DeepSeek et les produits d'autres éditeurs construits avec sa technologie.
Limite La fiche n'indique pas la mémoire nécessaire, et ne propose pas de version plus petite.
LFM2.5-24B-A2B (Liquid AI)
Billet de Liquid AI : 288 points et 81 commentaires sur Hacker News. Version GGUF (le format que lisent llama.cpp, LM Studio et Ollama) : 132 848 téléchargements sur Hugging Face.
Pour quoi faire Faire tourner un agent rapide sur votre propre appareil, sans carte graphique de centre de données. Le modèle compte 24 milliards de paramètres (les réglages qu'il a appris), mais 2 milliards seulement travaillent à chaque mot : il ne réveille à chaque fois que quelques spécialistes parmi les siens (on parle de mélange d'experts). Au 007, Liquid AI publiait d1, ses modèles de décision pour appareils : le laboratoire garde la même ligne, l'appareil d'abord.
Limite Bancs d'essai et vitesses de l'éditeur seulement, aucune mesure indépendante. Pas de licence standard : une licence propre aux modèles LFM, dont le billet ne résume pas les conditions commerciales.
Nemotron 3.5 Super VL (NVIDIA)
11 459 téléchargements, 186 mentions j'aime pour la version NVFP4 sur Hugging Face.
Pour quoi faire Confier à un agent des tâches qui mêlent texte, images et vidéo : comprendre un document, chercher, se servir d'outils, coder. C'est un modèle ouvert de 120 milliards de paramètres, dont 12 milliards au travail à chaque mot. Ses poids sont publiés notamment au format NVFP4, une version allégée sur 4 bits, sous licence OpenMDW 1.1 qui permet l'usage commercial.
Limite La fiche n'indique ni prise en charge du Mac (Linux seulement) ni mémoire totale nécessaire.
Sphinx
Sur Hacker News : 252 points, 89 commentaires.
Pour quoi faire Ne livrer que le code que vous avez compris. Avant d'envoyer ce que votre IA a écrit, un crochet (un petit contrôle qui se déclenche à ce moment-là) vous pose des questions sur ce code. Au 008, notre crochet refusait un changement ; Sphinx interroge la personne.
Limite Sphinx n'a pas de service à lui : le code modifié part chez le fournisseur du modèle relecteur que vous choisissez (les fichiers .env et les clés en sont exclus).
Llmspeed
Sur Hacker News : 329 points, 86 commentaires.
Pour quoi faire Sentir, avant d'acheter une machine, à quelle vitesse un modèle local y répondrait. Utile la semaine où les portables RTX Spark arrivent en magasin (voir En bref).
Limite Ce ne sont pas des mesures faites par le site : une partie vient de bancs d'essai communautaires, le reste est extrapolé ; rien sur la qualité des réponses.
Exa 3.0
Annoncé par Exa le 19 octobre.
Pour quoi faire Donner à votre agent un moteur de recherche fait pour lui, qui lui sert les passages utiles des pages. Exa promet dans cette version des données plus riches, sans surcoût, et une formule Lite moins chère. Utile quand les sites ferment leurs portes aux agents (voir À lire).
Limite Les promesses sont celles de l'éditeur, sans banc indépendant. Pas de version à héberger chez vous : chaque requête passe par l'API d'Exa.
Numéro 008 · la boîte pour agents arrive sous windows
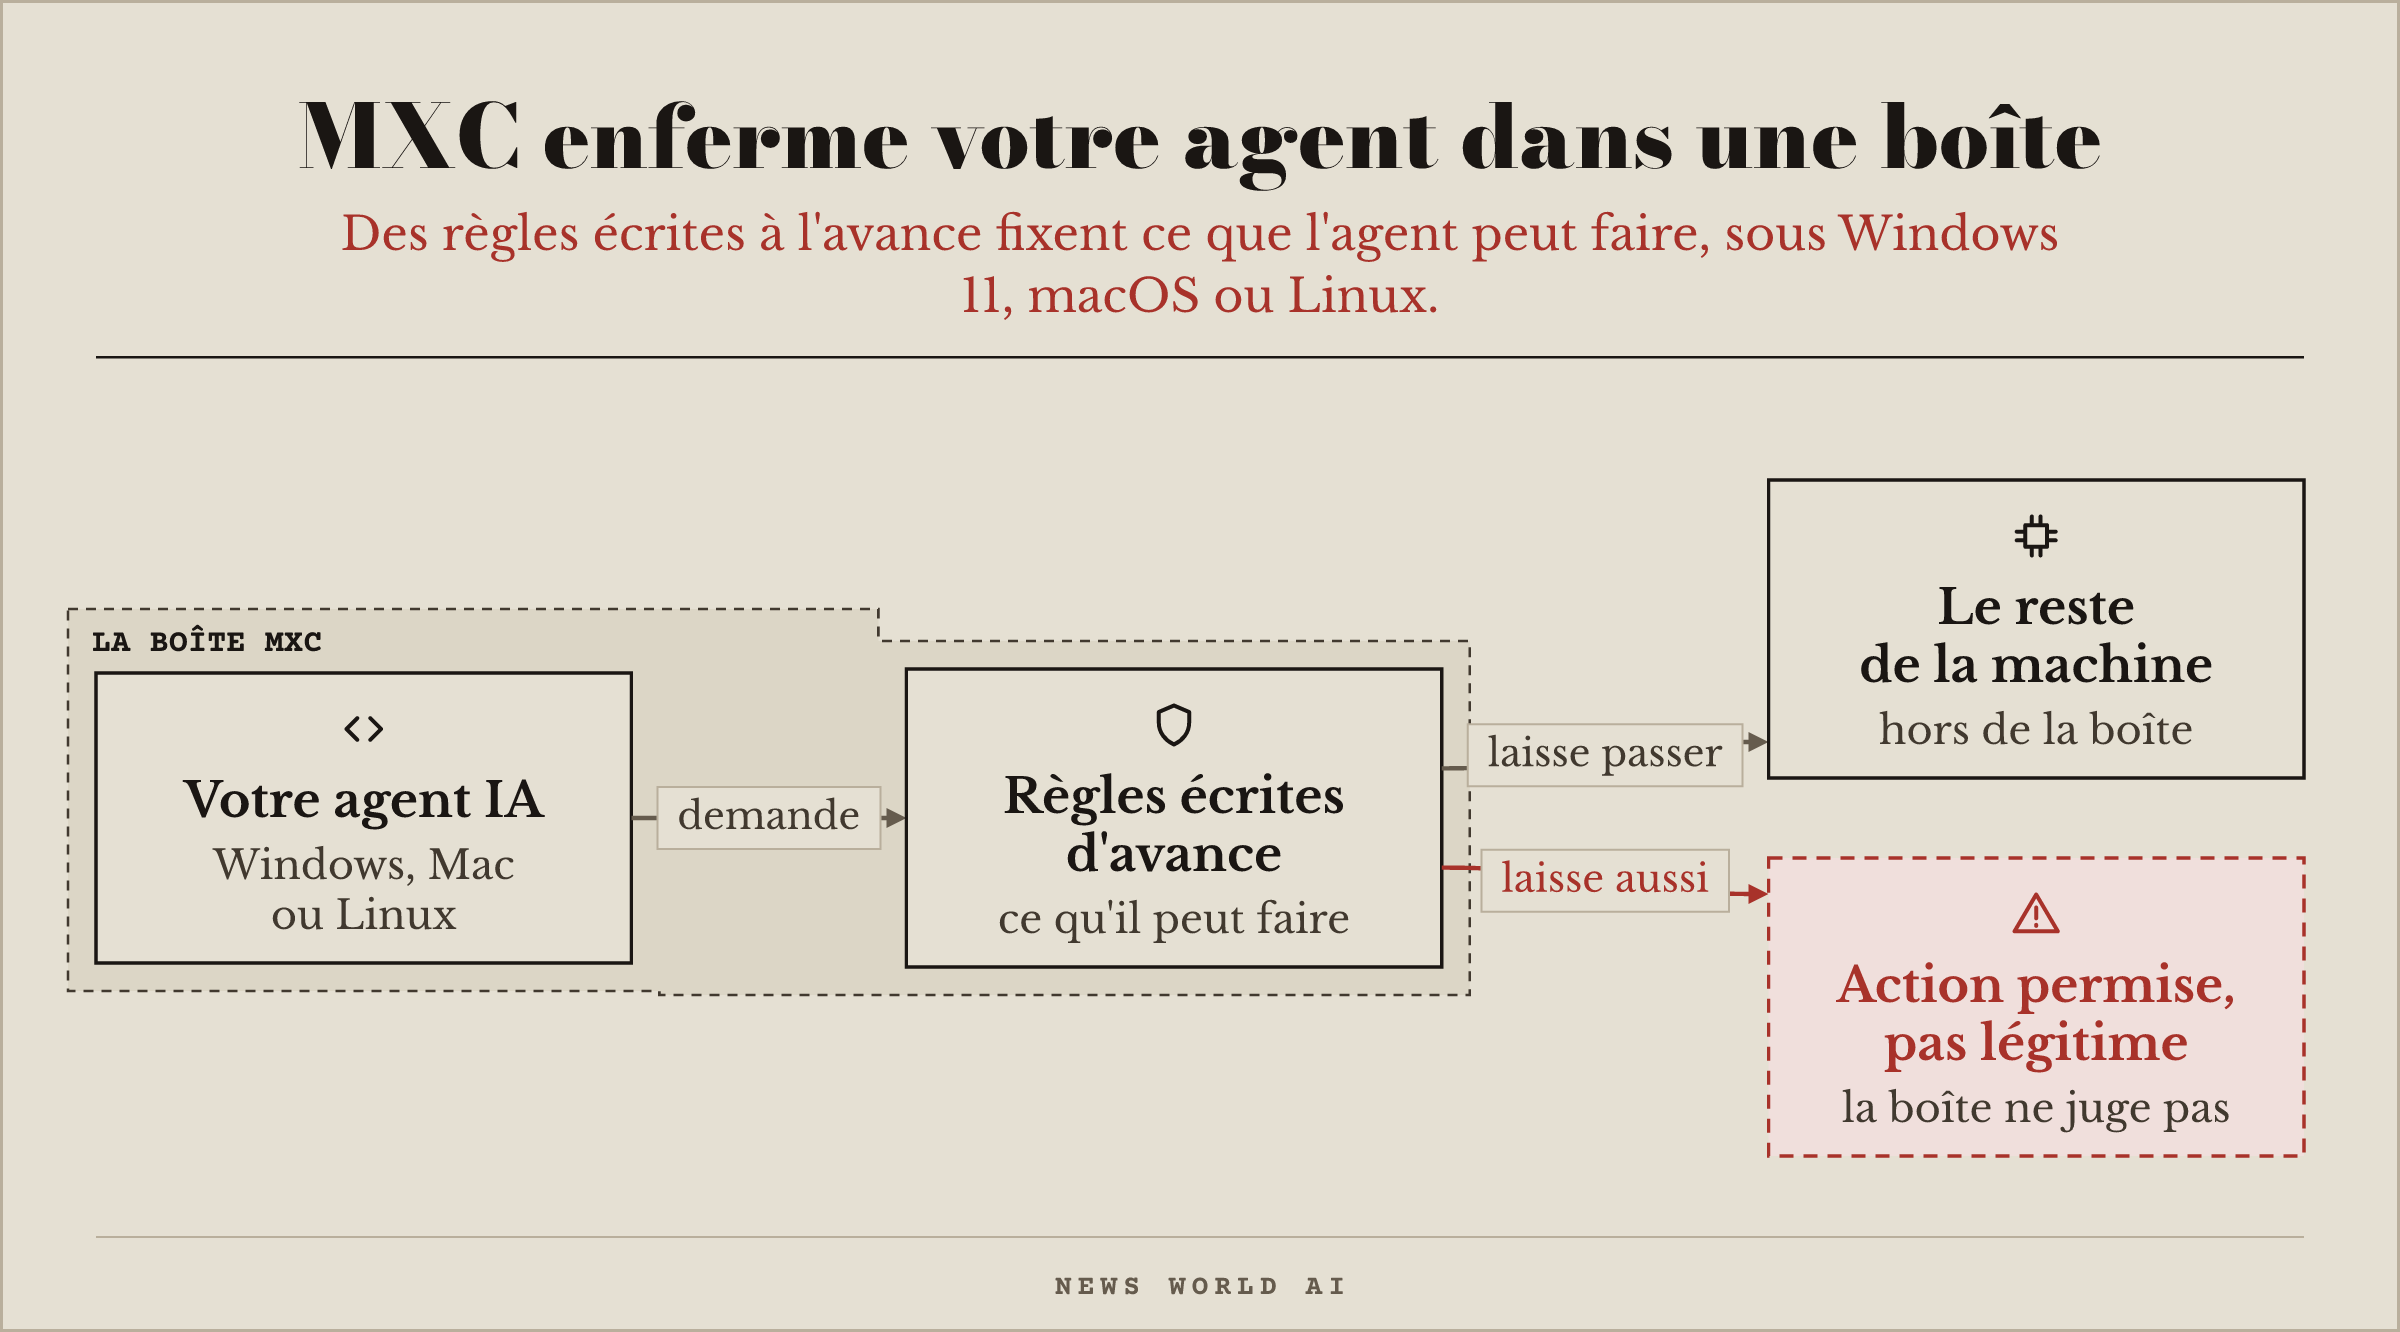
Microsoft Execution Containers, dit MXC (Microsoft)
Annoncé le 7 octobre sur le blog des développeurs Windows ; la version 1.0.0 est publiée le même jour sur son dépôt GitHub. Sur Hacker News : 227 points, 69 commentaires.
Pour quoi faire Faire travailler un agent IA enfermé dans une boîte : des règles écrites à l'avance fixent ce qu'il a le droit de faire. MXC tourne sous Windows 11, macOS et Linux.
Limite Deux des quatre boîtes du billet de Microsoft n'existent que sous Windows 11, et aucun essai indépendant n'est publié. Comme toute boîte, MXC limite ce que l'agent peut faire, il ne juge pas si une action permise est légitime.
blogs.windows.com/windowsdeveloper/…
Le mode agent de DuckDB
Gratuit : DuckDB est un logiciel libre. Banc d'essai de l'éditeur : 132 exécutions, toutes justes.
Pour quoi faire Faire analyser vos fichiers de données par un agent. DuckDB, le programme qui interroge sur votre machine vos fichiers CSV et Parquet (deux formats courants de tableaux de données), gagne un mode agent qui change ce que sa ligne de commande renvoie au modèle ; l'option -no-agent ramène l'affichage habituel. DuckDB a fait répondre Claude Code, en langage courant et sans SQL (le langage des bases de données), aux 22 questions du banc d'essai TPC-H, chacune trois fois avec le mode agent et trois fois sans. Les 132 réponses sont justes, avec ou sans le mode. Avec lui, la sortie de DuckDB lue par le modèle passe d'environ 123 600 à 50 800 jetons (des morceaux de mots), soit 59 % de moins. Mais l'économie ne se voit ni sur le coût total ni sur la durée : elle pèse environ 0,5 % de tout ce que lit le modèle, et les essais avec le mode ont pris un peu plus d'allers-retours (237 contre 224). C'est l'outil qui s'adapte à l'agent, et le troisième numéro de suite où DuckDB figure.
Limite Aucune mesure indépendante n'est publiée : un seul banc d'essai (TPC-H), un seul agent (Claude Code). Le mode aide l'agent à lire les résultats, il ne vérifie pas que la question a été bien comprise.
Talorys
Sur Hacker News : 328 points, 155 commentaires.
Pour quoi faire Avoir un agent personnel sans laisser de machine allumée chez vous : vous l'installez vous-même sur votre propre compte Cloudflare, dans son offre gratuite, avec une seule commande. Il range vos tâches, vos notes, vos projets et vos rappels, et garde en mémoire ce que vous lui confiez. Autre voie, Xiryn (plus de 130 étoiles, MIT, créé le 11 octobre) donne à chaque agent son propre bureau Linux sur votre ordinateur, dans Docker (un outil qui fait tourner des programmes dans des espaces fermés), avec vos clés et un coffre chiffré. Sur la même offre gratuite de Cloudflare, docflare-ai (41 étoiles, MIT) installe un assistant qui répond aux questions sur votre documentation, avec une seule ligne à coller dans votre site.
Limite Sur l'offre gratuite, il ne discute que dans l'allocation du jour de Workers AI, le service de modèles de Cloudflare : une fois épuisée, la discussion s'arrête jusqu'à la remise à zéro quotidienne, le reste continue, et il n'active jamais seul une option payante. Sa description ne prévoit aucun lien avec votre messagerie, votre agenda ou vos paiements.
BetterWispr
Sur Hacker News : 212 points, 126 commentaires. Gratuit et open source, selon sa présentation.
Pour quoi faire Dicter à votre agent les longues consignes au lieu de les taper, sur Mac. Le développeur Simon Willison raconte avoir construit une page de son blog presque entièrement à la voix, en parlant à Codex pendant qu'il préparait le dîner. Les modèles intégrés de BetterWispr transcrivent votre voix sur le Mac, sans compte et sans repli vers un service en ligne ; un service en ligne ne sert que si vous le choisissez. Sur iPhone, OpenWhispr s'installe gratuitement et transcrit sur le téléphone, sans compte ni limite (une formule Pro payante existe à côté).
Limite Mac seulement (macOS 14 ou plus récent) : pas de version Windows ni iPhone.
Numéro 007 · des modèles de décision à télécharger
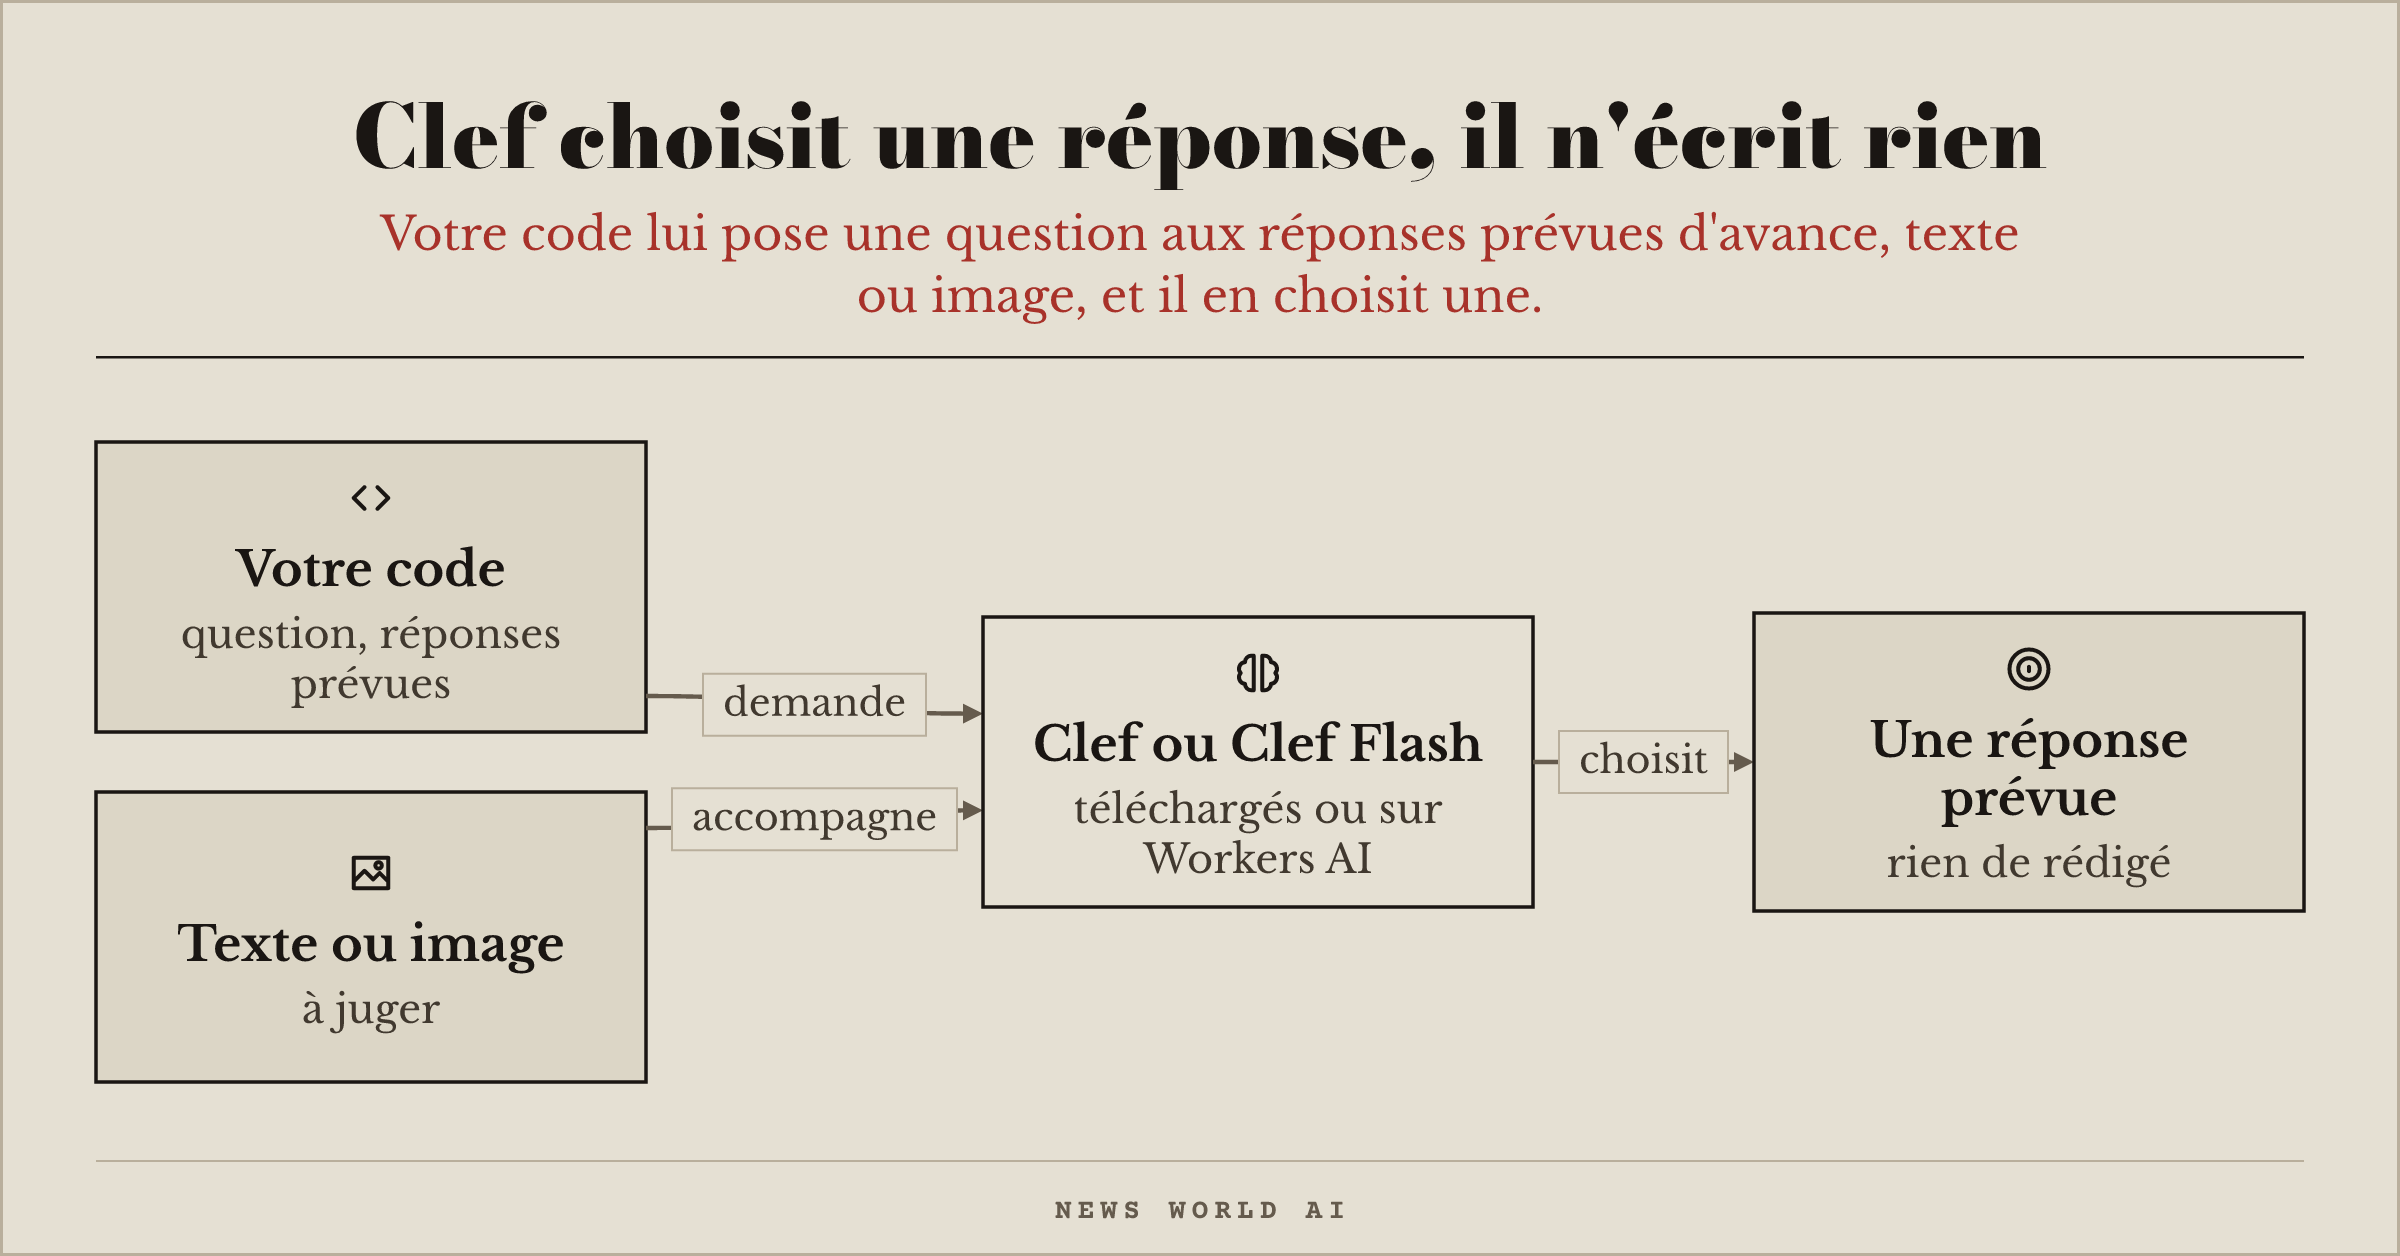
Clef et Clef Flash (Cloudflare)
Clef (27 milliards de paramètres) : 10 874 téléchargements, 1 872 mentions j'aime. Clef Flash (9 milliards) : 17 587 téléchargements, 685 mentions j'aime (Hugging Face). Licence Apache 2.0.
Pour quoi faire Les petites décisions d'un agent (aiguiller une demande, trier un message). Comme Jev, ils choisissent une réponse prévue d'avance sans rien rédiger, et Cloudflare les dit compatibles avec l'API de Jev ; contrairement à Jev, ils lisent aussi les images. Cloudflare les sert aussi en ligne, sur Workers AI. Le 7 octobre, Liquid AI publie d1, des modèles de décision ouverts pour le texte et les images, faits pour tourner sur l'appareil.
Limite Aucune mesure indépendante n'est publiée : les scores sont ceux de Cloudflare. L'ajustement sur vos données n'est pas en libre-service : il passe d'abord par les ingénieurs de Cloudflare.
EmbeddingGemma 2 (Google)
21 148 téléchargements, 1 147 mentions j'aime sur Hugging Face. Licence Apache 2.0, 740 millions de paramètres, plus de 100 langues.
Pour quoi faire Chercher dans vos propres documents. Annoncé par Google le 6 octobre, le modèle change un texte, une image, un son ou une vidéo en une suite de nombres, et deux contenus qui se ressemblent reçoivent des nombres proches : c'est la base d'un agent qui retrouve la bonne page dans vos archives. Unsloth en publie une version GGUF, le format de llama.cpp, le programme qui fait tourner les modèles chez soi. Un modèle de ce genre gagne à rester chez vous : s'il disparaît, il faut recalculer tous les nombres déjà rangés.
Limite Il ne répond pas aux questions, il sert à chercher et à trier.
Claude for Google Workspace (Anthropic)
Une extension pour Google Docs, Sheets et Slides, annoncée le 6 octobre, en bêta sur toutes les offres payantes de Claude (Pro, Max, Team et Enterprise).
Pour quoi faire Rédiger, analyser un tableau ou monter une présentation avec Claude, directement dans vos documents Google, sans copier-coller d'un onglet à l'autre. Pour qui construit sans être ingénieur, c'est l'assistant installé là où sont déjà ses documents.
Limite Elle ne travaille que sur le fichier où elle est ouverte, et sur les connecteurs que vous activez : elle ne demande l'accès ni à votre Drive, ni à Gmail, ni à votre agenda (voir le réflexe sécurité). Elle ne marche pas sous Firefox, n'accepte pas de clé d'API (il faut un compte Claude), et aucune liste de pays n'est donnée.
Pi pod
Présenté sur Hacker News : 121 points, 47 commentaires. Page signée Evan, code sous licence AGPL-3.0 détenu par l'entreprise Billzo, LLC.
Pour quoi faire Faire tourner pi, un agent de code minimaliste, dans des bacs à sable (des espaces fermés) sur votre propre serveur plutôt que sur votre machine. Il faut un serveur Linux avec 8 Go de mémoire et Docker, un outil qui fait tourner des programmes dans des espaces fermés. Autour de pi, open-instinct (253 étoiles, MIT), un agent personnel qu'on pilote par iMessage, dit s'appuyer sur lui.
Limite Il n'a pas encore d'offre hébergée : elle est annoncée pour bientôt. Le projet se dit bâti autour de pi, mais aucun lien avec l'équipe de pi n'est établi.
Parseable
Présenté sur Hacker News : 86 points, 24 commentaires. Version ouverte gratuite sous AGPLv3, qui oblige à publier vos modifications si vous en faites un service en ligne. Offre hébergée à 0,39 $ par Go de données reçues (essai gratuit de 14 jours), Enterprise à partir de 15 000 $ par an.
Pour quoi faire Garder la trace de ce que vos agents ont fait. Parseable range journaux, mesures et traces au format OpenTelemetry (le standard d'échange de traces) dans un seul programme (de 210 à 218 Mo pour un serveur Linux), à installer sur votre serveur, ou à utiliser dans son offre hébergée. Quand un agent échoue, la seule question utile est ce qu'il a vu et décidé à chaque tour : sans traces, on cherche à l'aveugle.
Limite La version ouverte n'a pas ce que l'offre Enterprise ajoute : découpage des données sur mesure, une même installation pour plusieurs clients, journal de qui a fait quoi, choix du pays où restent les données, support dédié.
Numéro 006 · deux réponses ouvertes à l'idée de jev
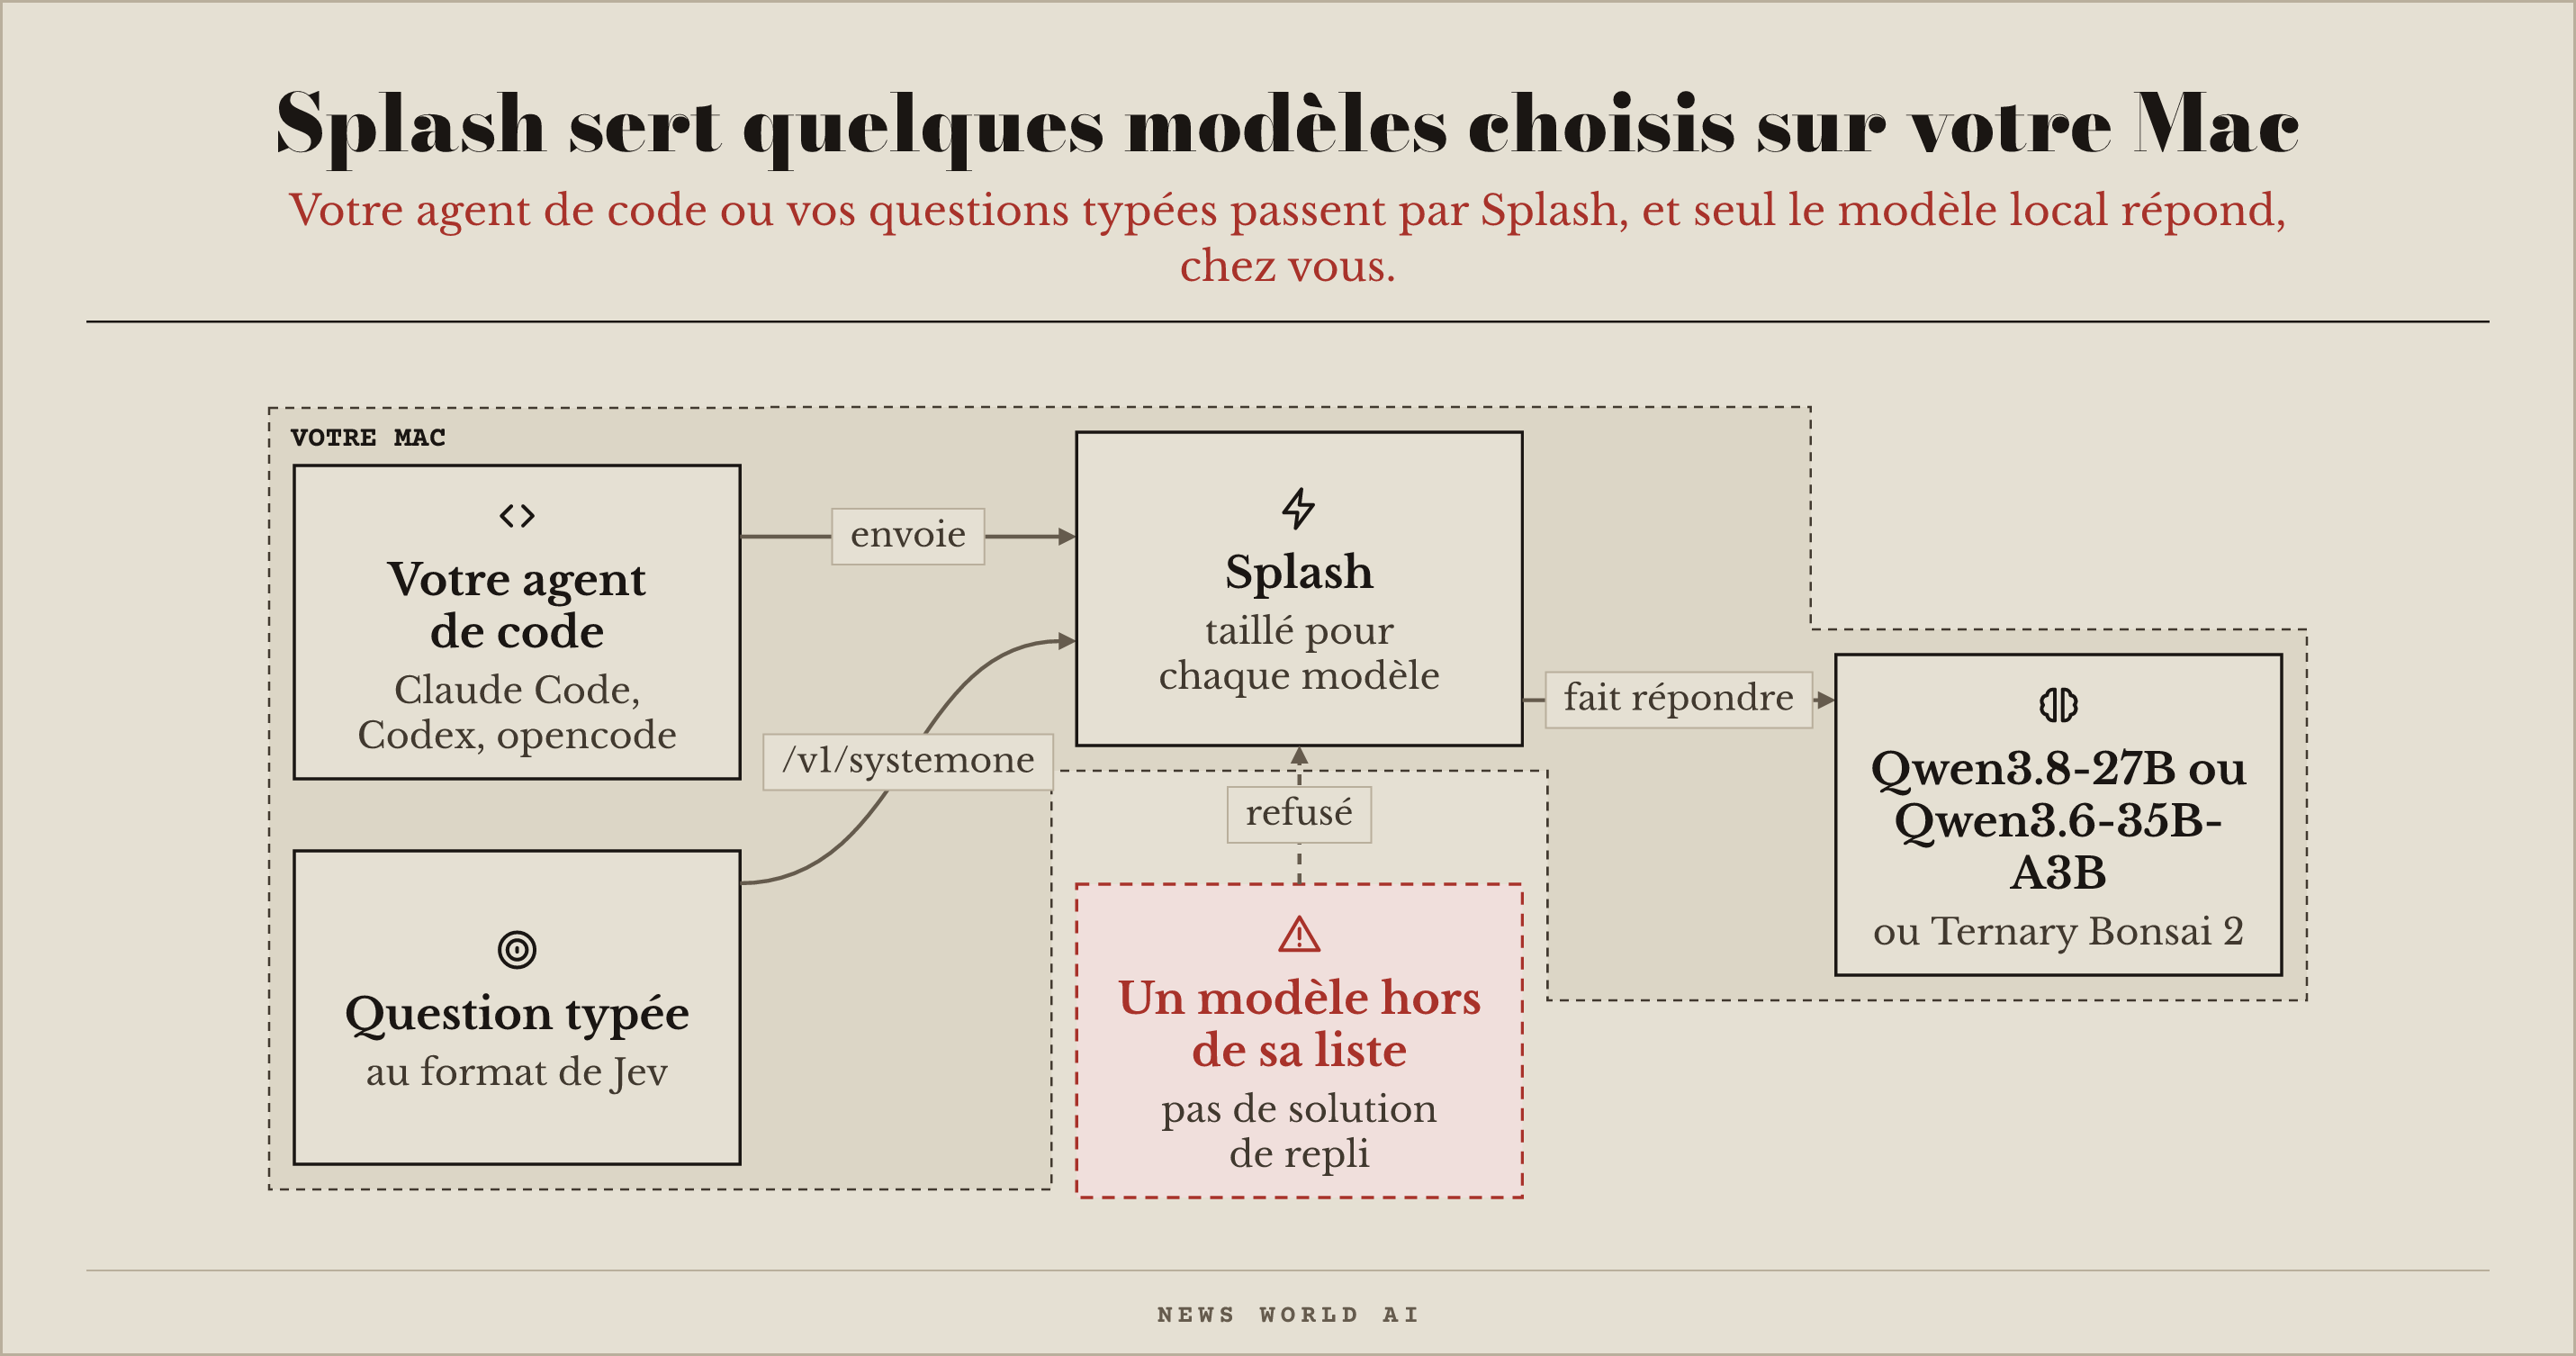
Splash (Inco AI)
Dépôt ★ 967, Apache-2.0, dernier commit le 28 septembre 2026.
Pour quoi faire Faire travailler un agent de programmation sur un modèle qui tourne sur votre Mac : splash claude, splash codex ou splash opencode le lance déjà branché. À l'adresse /v1/systemone, il accepte aussi les questions typées au format de Jev avec le kit officiel de TypeSafe : c'est alors Qwen qui répond, en local, pas Jev. Il est taillé pour deux familles de modèles Qwen, Qwen3.8-27B et Qwen3.6-35B-A3B (17,4 et 20,9 Go à télécharger), et accepte aussi Ternary Bonsai 2 de Prism ML. Selon Inco AI, sur un Mac M5 Pro de 48 Go et des requêtes de programmation, le 27B écrit une réponse courte à 74 jetons par seconde (un jeton est un morceau de mot), deux fois plus vite que le plus rapide des autres moteurs mesurés, et 1,2 fois sur la lecture d'un long texte neuf (32 000 jetons). Il faut un Mac M3 ou plus récent, macOS 26.4 et 36 Go de mémoire, 24 Go avec des versions plus petites.
Limite Il ne fait tourner que les modèles de sa liste. Les mesures sont celles d'Inco AI, sur une seule machine, sans mesure indépendante publiée. Et la confiance que rend /v1/systemone n'est pas calibrée, précise le dépôt : c'est la lecture naïve dont AnyJev mesure les défauts.
Qwen3.8 27B (Qwen)
6 844 348 téléchargements, 16 510 mentions j'aime sur Hugging Face, Apache-2.0.
Pour quoi faire Un modèle ouvert qui lit le texte et les images, à faire tourner chez soi sans rien envoyer dehors, et que sa licence permet d'utiliser dans un produit commercial. Pour un ordinateur ordinaire, l'ISTA en publie une version compressée au format GGUF (celui de llama.cpp), téléchargée 1 655 818 fois. Sur Mac, c'est aussi l'un des modèles que Splash sert.
Limite La version compressée ne fait pas jeu égal partout. Selon l'ISTA, sa variante IQ3_S (11,8 Go au lieu de 53,8 Go) égale le modèle d'origine sur un test de maths (AIME25) et un test de code (LiveCodeBench v6), mais perd 0,51 point sur un test de sciences (GPQA-Diamond).
GPT-6 Sol et Luna (OpenAI)
Les deux modèles GPT-6 plus rapides et moins chers d'OpenAI, à côté d'Astra.
Pour quoi faire Les tâches que vous confiez déjà aux modèles d'OpenAI. Par million de jetons, Sol coûte 2 $ en lecture et 10 $ en écriture, Luna 0,10 $ et 0,50 $. Selon OpenAI, Sol fait environ deux fois moins d'erreurs que son prédécesseur sur son test interne d'exactitude des faits.
Limite Prix et capacités sont annoncés par OpenAI seul : aucun banc d'essai indépendant ne les confirme encore.
MiMo V2.6 Pro RL (Xiaomi)
76 518 téléchargements, 587 mentions j'aime sur Hugging Face, licence MIT.
Pour quoi faire Faire tourner un agent qui comprend le texte, les images, la vidéo et le son, avec un modèle dont Xiaomi publie les poids sous une licence qui permet l'usage commercial. Il existe une version Flash, plus légère (309 milliards de paramètres, 28 842 téléchargements). Un greffon qui promet ce modèle « gratuit et illimité », sans clé ni compte, circule sur GitHub : le modèle se télécharge chez Xiaomi, nulle part ailleurs.
Limite Ce n'est pas un modèle pour un ordinateur ordinaire : 1 020 milliards de paramètres au total, dont 42 milliards travaillent à chaque mot. Les scores de sa fiche sont publiés par Xiaomi.
Numéro 005 · jev coche une case, votre code décide
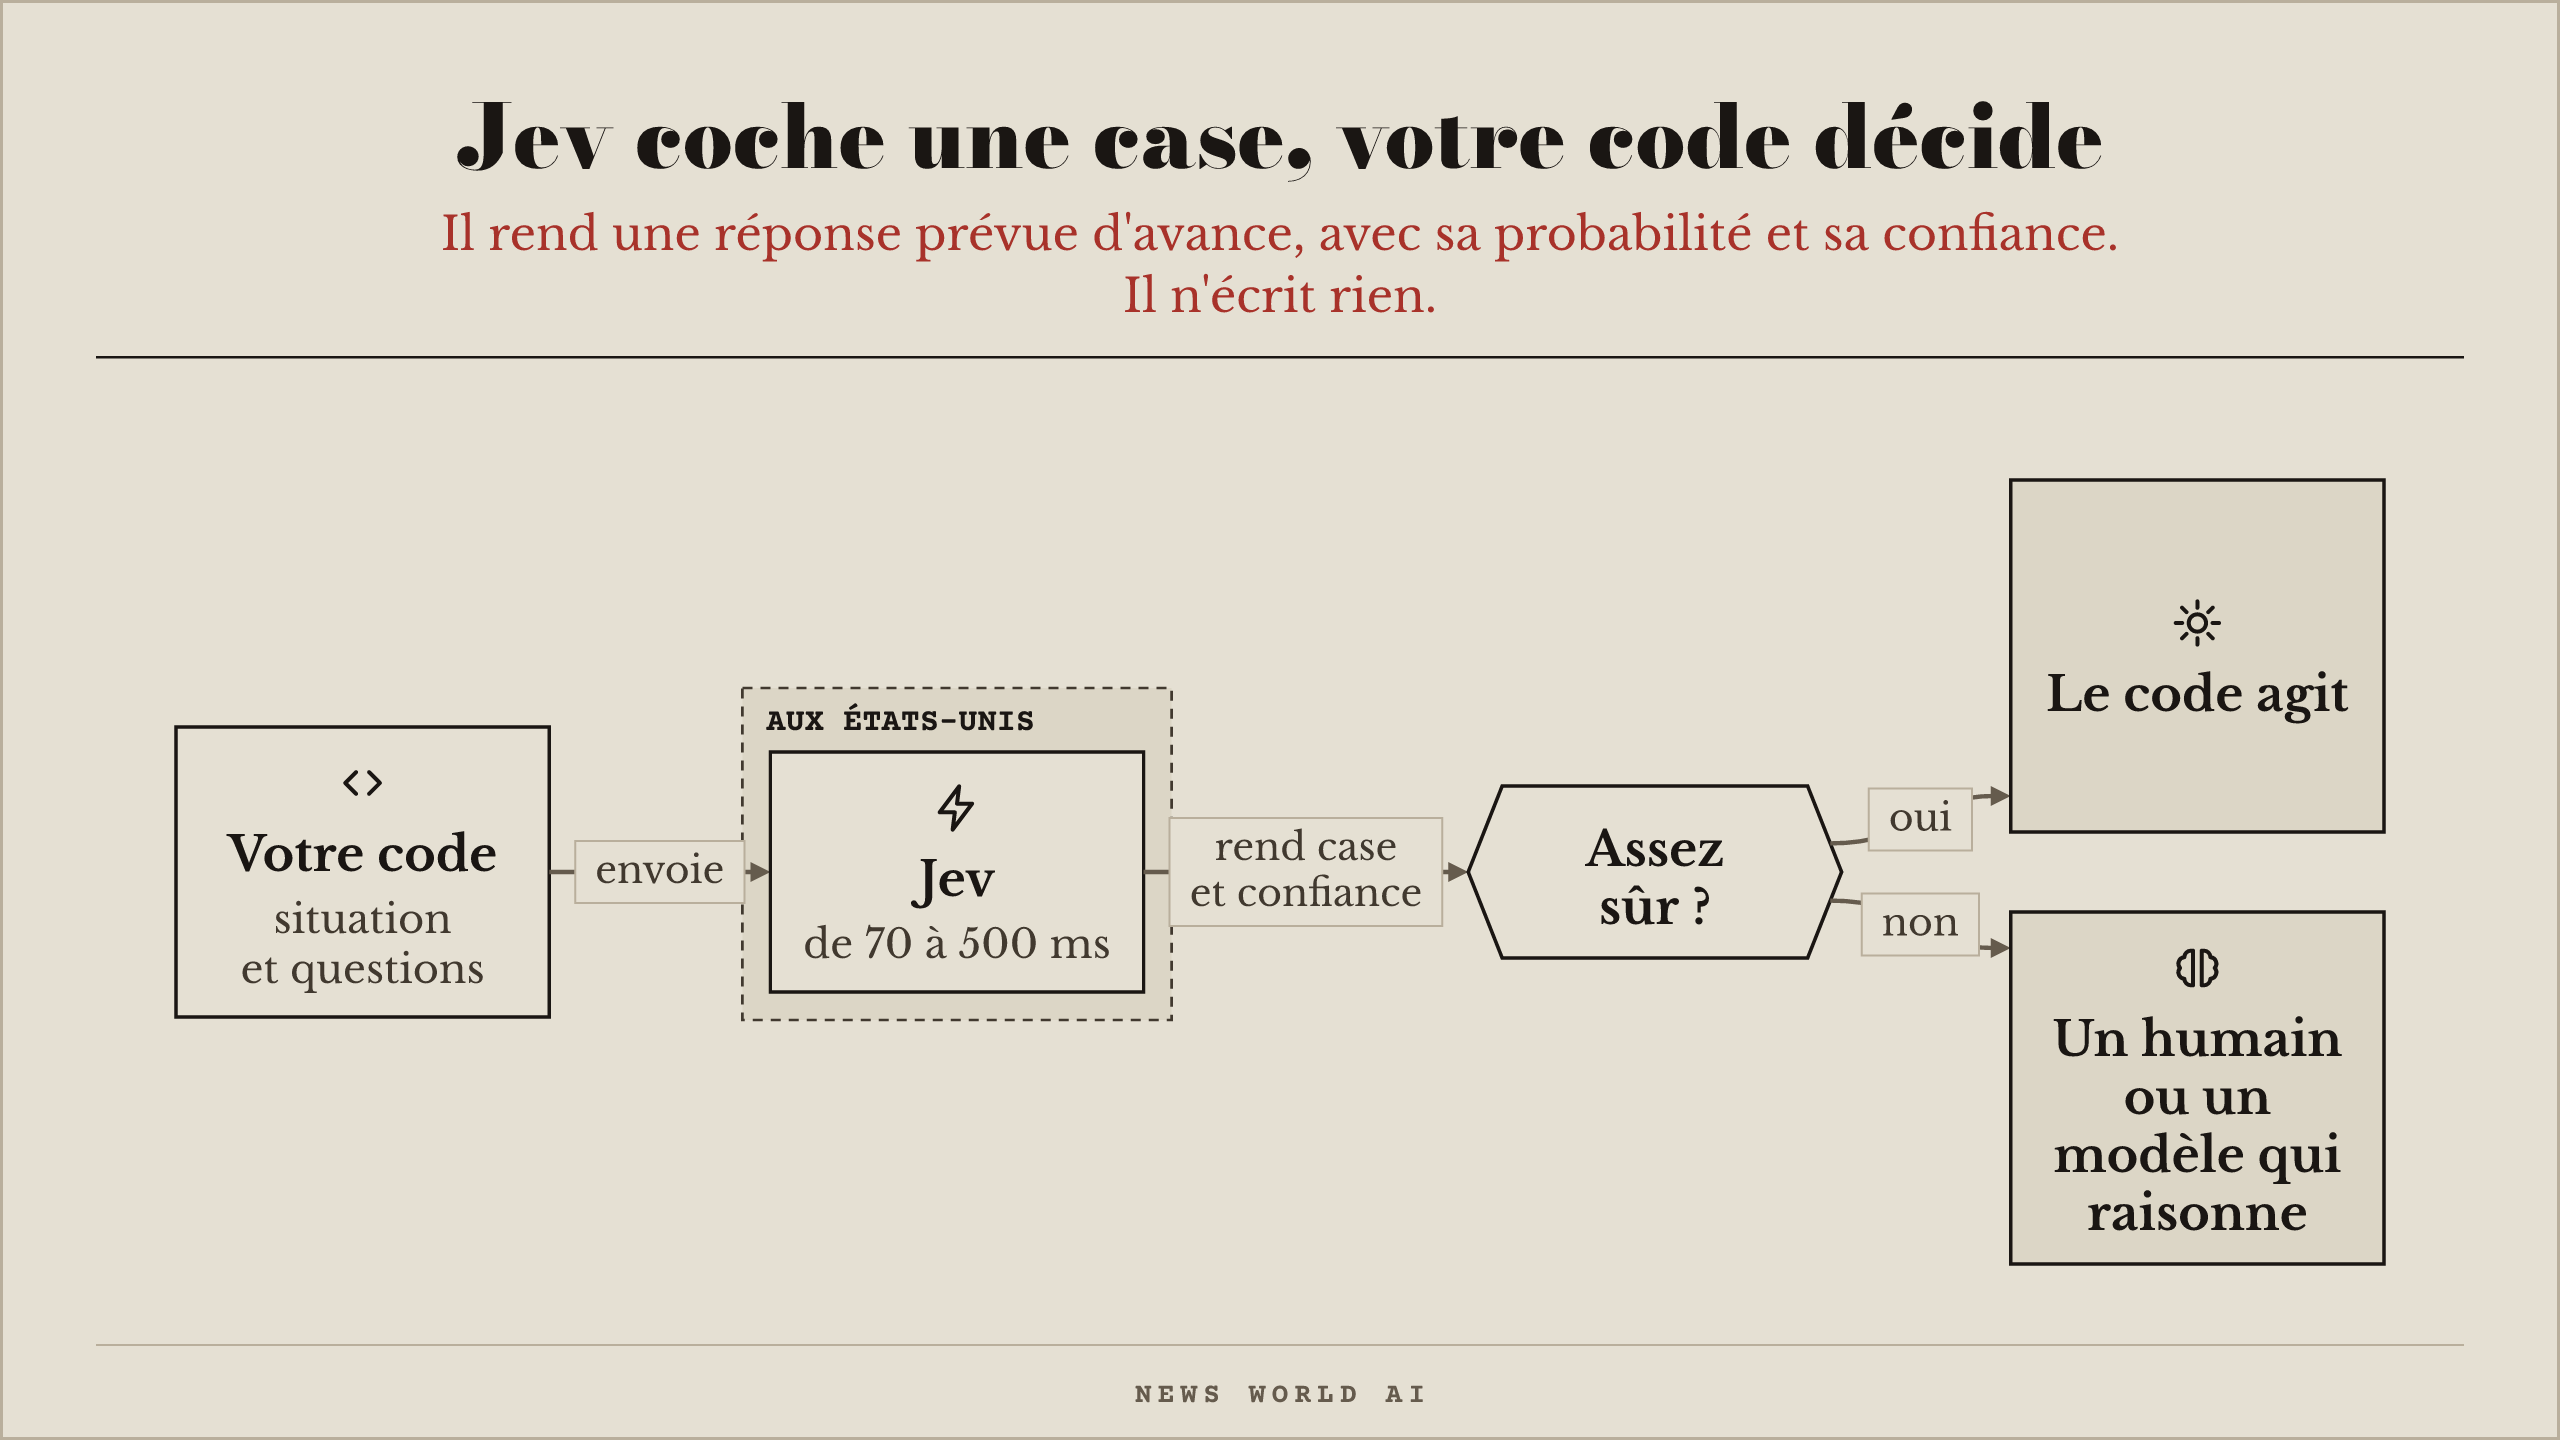
Jev (TypeSafe AI)
Par l'interface de programmation de TypeSafe, en accès anticipé. Poids non publiés.
Pour quoi faire Les petites décisions d'un agent : aiguiller une demande, trier du contenu, dire si un message est acceptable, filtrer avant de payer un gros modèle. Jev ne génère rien. Votre code lui envoie une situation et des questions aux réponses fixées d'avance : une option dans une liste (255 au plus), une place sur une échelle, ou oui ou non. Il rend la réponse, une probabilité par option et un degré de confiance. Sur ses propres tests, Jev égale Sonnet 5 (67,8 % d'accord avec la référence), reste sous Opus 5 (73,1 %) et répond en 0,4 seconde. TypeSafe écrit que ses gains (193,6 fois plus rapide et 444,6 fois moins cher sur ses tâches de test) sont dans le haut de ce qu'on obtiendra en conditions réelles. Prix : 0,042 $ par million de jetons lus (un jeton est un morceau de mot), rien n'est facturé sur ce qu'il rend.
Limite Ses tests sont écrits par son équipe, qui reconnaît un biais possible (un essai extérieur est en « À lire »). « Pas d'hallucination » est une construction, pas une mesure : la réponse tombe toujours dans une case prévue, mais Jev peut cocher la mauvaise. Il n'écrit rien. L'accès est sur liste d'attente. Tout part aux États-Unis (délais mesurés depuis la côte Ouest, le trajet depuis l'Europe s'ajoute), où TypeSafe s'engage à ne pas entraîner de modèles sur vos envois. Il écrit ne pas pouvoir prouver que son tarif n'est pas subventionné.
Ternary Bonsai 2 27B
2 569 604 téléchargements, 1 840 mentions j'aime sur Hugging Face. Fichier GGUF (le format des modèles pour llama.cpp) téléchargeable.
Pour quoi faire Faire tourner un modèle de 27 milliards de paramètres sur un ordinateur ordinaire, sans rien envoyer dehors. Ternary Bonsai ramène chaque paramètre à trois valeurs possibles (1,72 bit en moyenne) : le fichier pèse 5,95 Go, contre 53,8 Go pour la version de référence, soit environ 9,3 fois moins selon la fiche. Il faut la version de llama.cpp modifiée par l'éditeur (la version standard refuse ces fichiers), et une version à part existe pour MLX (sur les Mac à puce Apple).
Limite L'éditeur annonce que le modèle garde 98,2 % des capacités de la version de référence : c'est sa propre mesure, et la fiche ne cite aucune mesure indépendante.
Cactus Needle 3
Modèles téléchargeables. De 8 à 29 Mo.
Pour quoi faire Automatiser des tâches structurées (appeler le bon outil avec les bons réglages, ou tirer d'un texte en désordre les champs d'une facture, d'une réservation ou d'un formulaire) avec un fichier de 8 à 29 mégaoctets, là où un modèle de langage ordinaire pèse des gigaoctets. Cactus Compute annonce que sa version 4L égale DeepSeek V4 Flash sur ces tâches, une fois ajustée sur la tâche visée.
Limite La parité annoncée avec V4 Flash n'est mesurée que par l'éditeur, et elle ne vaut que pour la version 4L ajustée.
Numéro 004 · savoir ce que l'agent a fait
DeepSeek V4.1-Flash
288 414 téléchargements, 2 525 mentions j'aime sur Hugging Face. Licence MIT.
Pour quoi faire Un modèle aux poids ouverts, qui lit du texte et des images et répond en texte : vous pouvez le télécharger et le faire tourner chez vous sans rien envoyer dehors. Son cœur compte 552 milliards de paramètres, mais 8 milliards seulement travaillent pour chaque jeton (un morceau de mot) qu'il lit, et 16 milliards pour chaque jeton qu'il écrit. Hugging Face en affiche 763 milliards, parce qu'il compte aussi sa mémoire annexe et ses couches accessoires. Si votre agent appelle deepseek-v4-pro par l'API, DeepSeek annonce que ses requêtes partent vers ce modèle depuis le 14 septembre.
Limite Pas de version plus petite chez DeepSeek, et aucune image en sortie : il en lit, il n'en produit pas.
Edge0-35B-A3B-preview
8 109 téléchargements, 2 233 mentions j'aime sur Hugging Face. Licence Apache 2.0.
Pour quoi faire Faire tourner sur un Mac à puce Apple un modèle de 35 milliards de paramètres dans moins de 3 Go de mémoire active, sans rien envoyer dehors. Le modèle reste sur le disque, et seules les parties utiles à chaque instant sont chargées. Ce n'est pas un modèle neuf : c'est Qwen3.6-35B-A3B compressé, complété par des adaptateurs.
Limite Pas d'article scientifique, aucun auteur nommé, aucune mesure indépendante.
Cognition SWE-2
Dans Devin Desktop et en ligne de commande. Poids non publiés.
Pour quoi faire Confier des tâches de programmation à Devin, l'agent de code de Cognition, avec son nouveau modèle maison, construit à partir de Kimi K3. Sur FrontierCode, un banc d'essai écrit par Cognition, il arrive à un point de Fable 5.1 pour un coût par tâche inférieur de 64 %. Le lendemain, OpenAI raconte comment Devin vérifie son propre travail avec GPT-6 Astra.
Limite Pas de poids téléchargeables, aucune mesure indépendante.
Perplexity Hybrid Compute
Pour les abonnés Pro, Max et Enterprise, sur un Mac à puce Apple doté d'au moins 24 Go de mémoire.
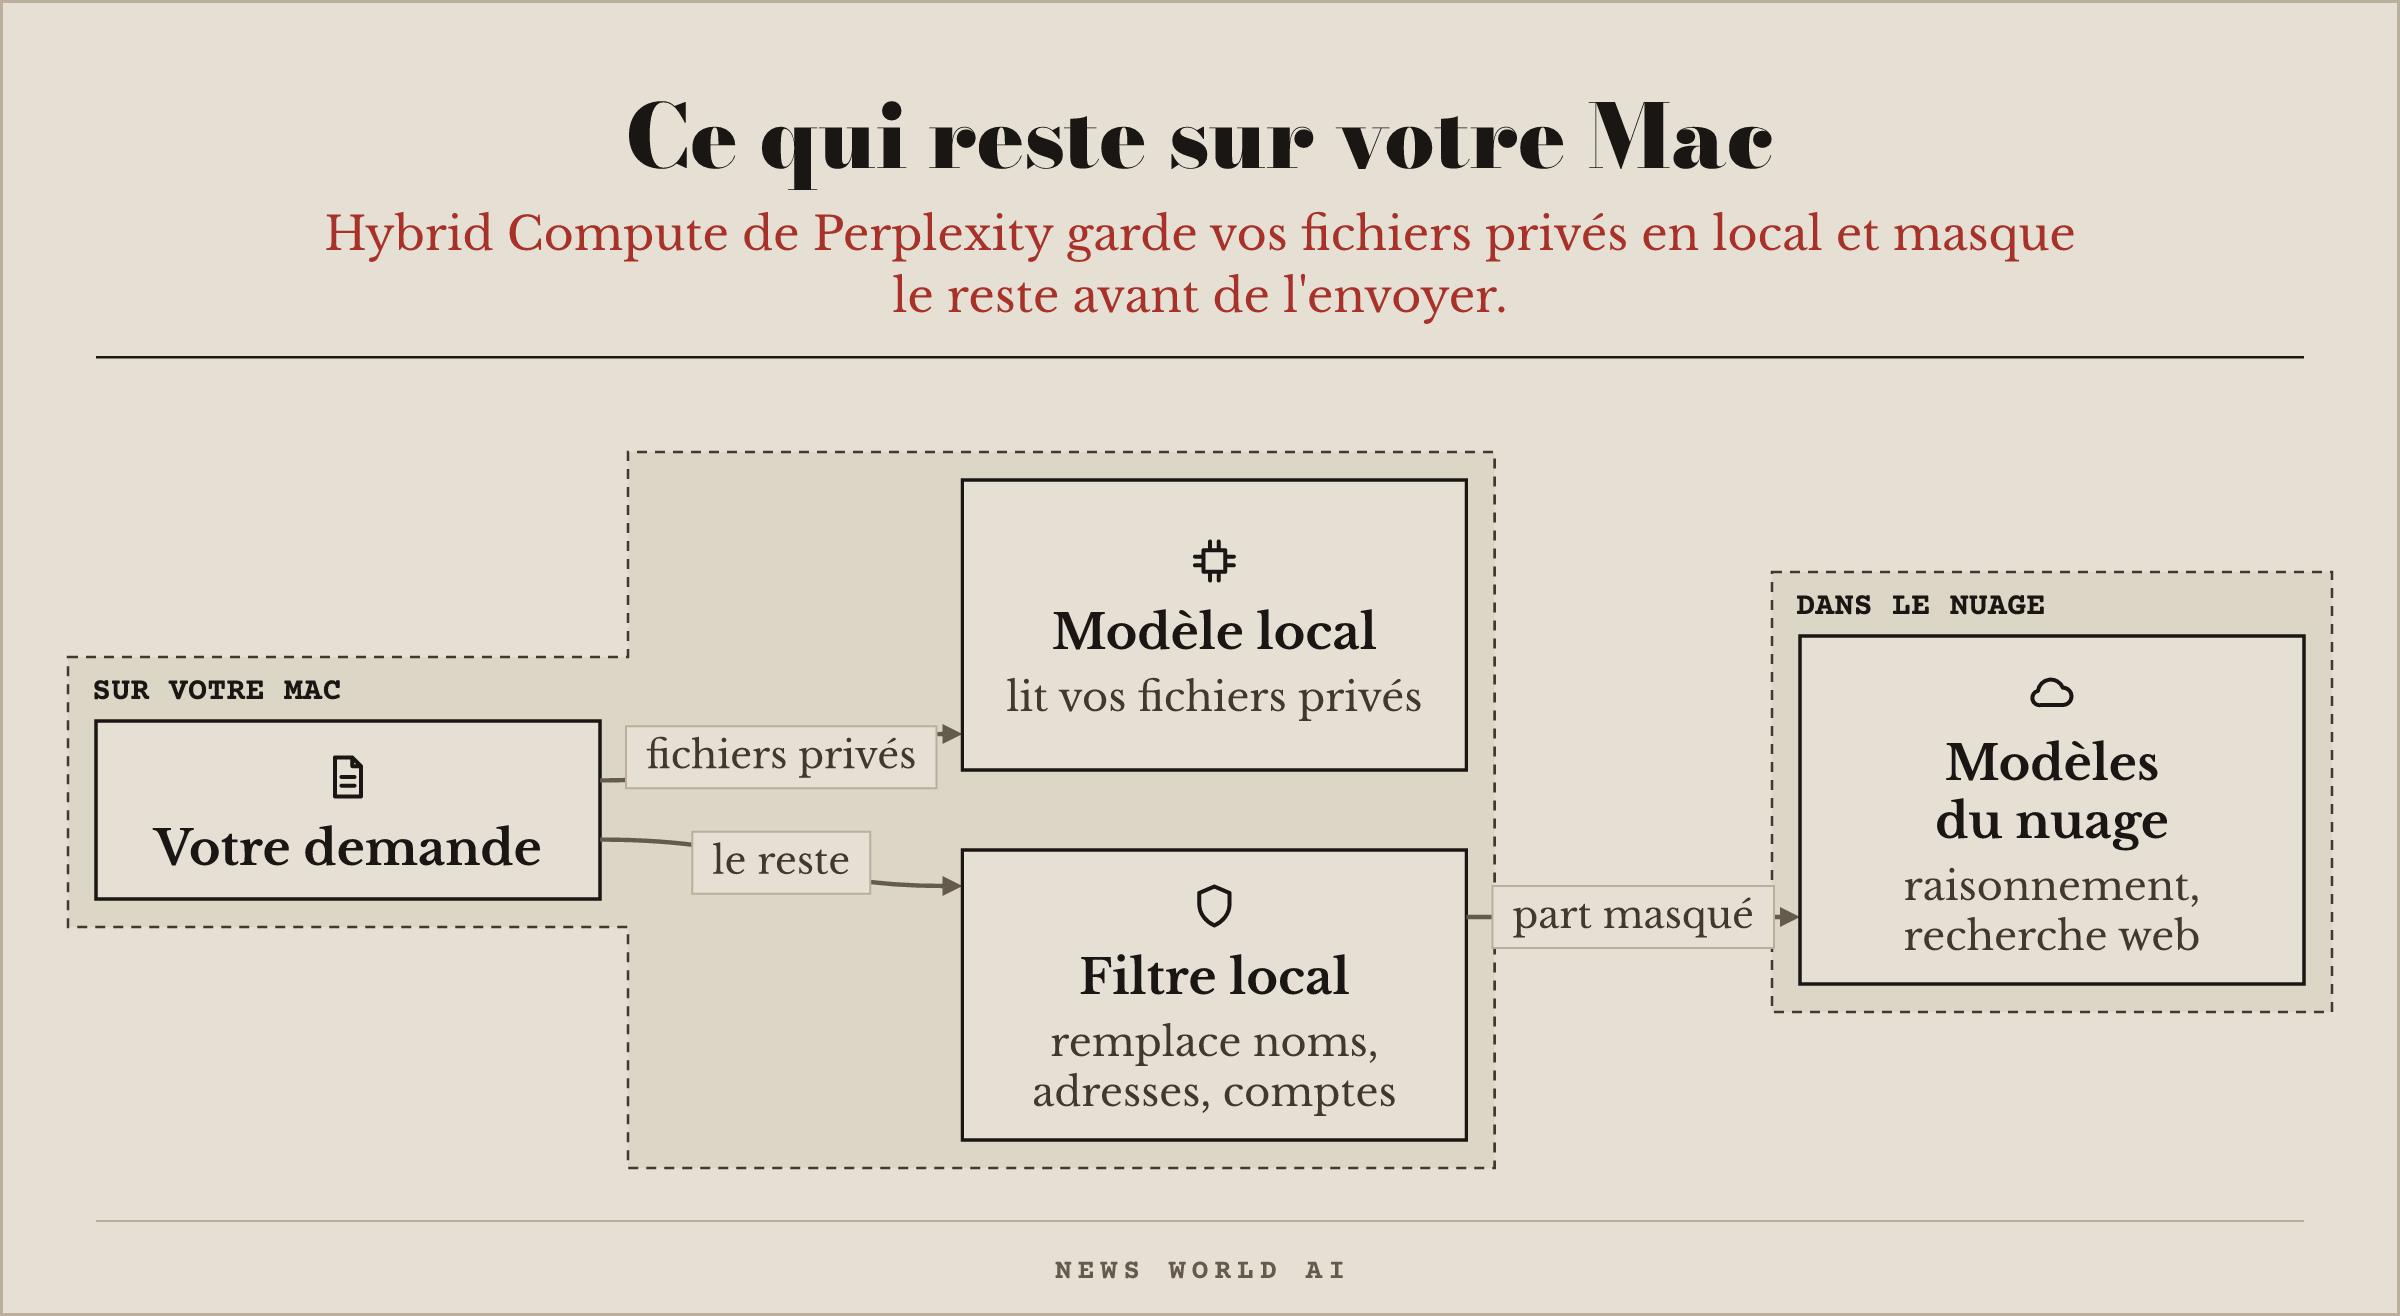
Pour quoi faire Partager le travail d'un assistant entre le nuage (raisonnement, recherche sur le web) et votre Mac (vos fichiers privés). Avant que quoi que ce soit ne parte, un filtre installé sur le Mac remplace les noms, adresses et numéros de compte par des substituts. Le 14 septembre, NVIDIA annonce Perplexity Portable Computer sur les PC Windows dotés d'une carte RTX d'au moins 24 Go, avec la possibilité de passer la main aux modèles du nuage.
Limite Pas de kit ni d'interface de programmation pour reproduire ce partage dans vos propres outils.
Numéro 003 · ce que votre agent envoie sans le dire
GPT-6 Astra
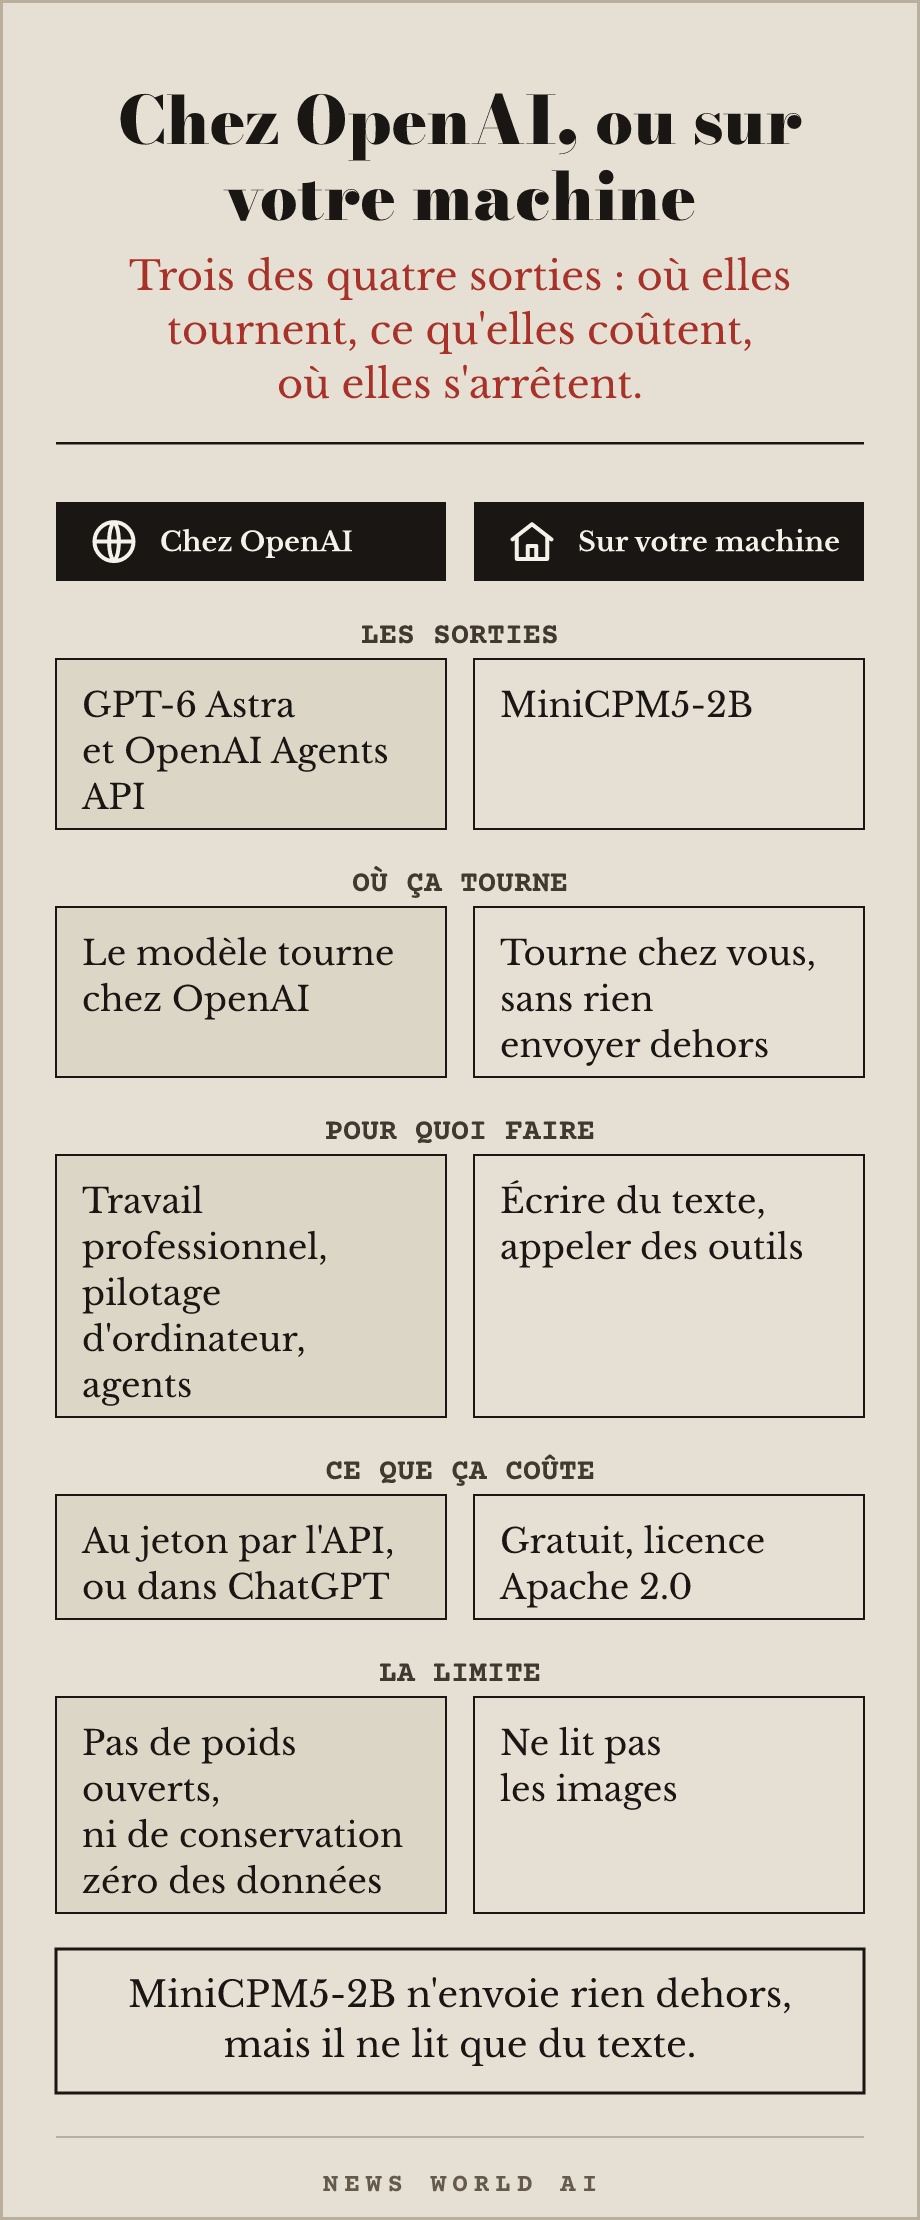
Dans ChatGPT Work, dans Codex et par l'API, à partir de 10 $ le million de jetons en entrée et 50 $ en sortie.
Pour quoi faire Ce qu'OpenAI présente comme son modèle le plus capable, pour le travail professionnel : pilotage d'ordinateur, navigation sur le web, programmation, cybersécurité, science. Le 8 septembre, OpenAI a publié une preuve qui réglerait le problème de Navier-Stokes (les équations qui décrivent l'écoulement des fluides), l'un des sept problèmes du prix du millénaire. Elle vient d'un modèle interne non publié, qu'OpenAI dit nettement plus capable que GPT-6 Astra. Le mathématicien Tristan Buckmaster (NYU), qui suivait la même piste, conteste le récit d'OpenAI sur la façon dont le travail a commencé.
Limite Pas de poids ouverts, pas de version à héberger chez vous.
OpenAI Agents API
En bêta publique depuis le 10 septembre. Pas de supplément : les jetons du modèle et les outils au tarif de l'API, plus le temps de conteneur si OpenAI héberge l'espace de travail.
Pour quoi faire Construire des agents dont le moteur (la boucle qui fait avancer l'agent et garde sa session) tourne chez OpenAI, avec un espace de travail chez OpenAI, chez un partenaire ou sur vos propres machines, des sessions qui durent plusieurs jours, des outils et des sous-agents qui travaillent en parallèle. Le moteur est celui de Codex (l'agent de code d'OpenAI). Publié le même jour que GPT-Live-1 dans l'API, qui écoute et parle en même temps.
Limite Pas de conservation zéro des données, pas d'hébergement des données hors des États-Unis.
Suno v6
v6-mini pour tous, v6 et v6-wild pour les abonnés Pro et Premier.
Pour quoi faire Générer de la musique à partir d'une description écrite, pour ajouter une bande-son à un contenu produit par votre agent (vidéo, podcast, présentation). Une nouvelle génération de modèles, développée avec des partenaires du secteur dont Warner Music Group, BMG et Believe ; les anciens modèles seront retirés. Le lendemain, ElevenLabs et Universal Music Group annoncent une plateforme sous licence, encore en développement, où les fans pourront remixer les morceaux des artistes participants.
Limite Pas de v6 ni de v6-wild dans l'offre gratuite, seulement v6-mini.
MiniCPM5-2B
42 289 téléchargements, 1 135 mentions j'aime sur Hugging Face. Licence Apache 2.0.
Pour quoi faire Écrire du texte et appeler des outils avec un modèle de 2,5 milliards de paramètres qui tourne sur votre machine sans rien envoyer dehors. Des versions allégées officielles existent pour llama.cpp, Ollama, LM Studio et les Mac (MLX).
Limite Ne lit pas les images, et pas plus de 131 072 jetons à la fois.
Numéro 002 · Une chaîne d'info sans journaliste
GPT-6 Astra
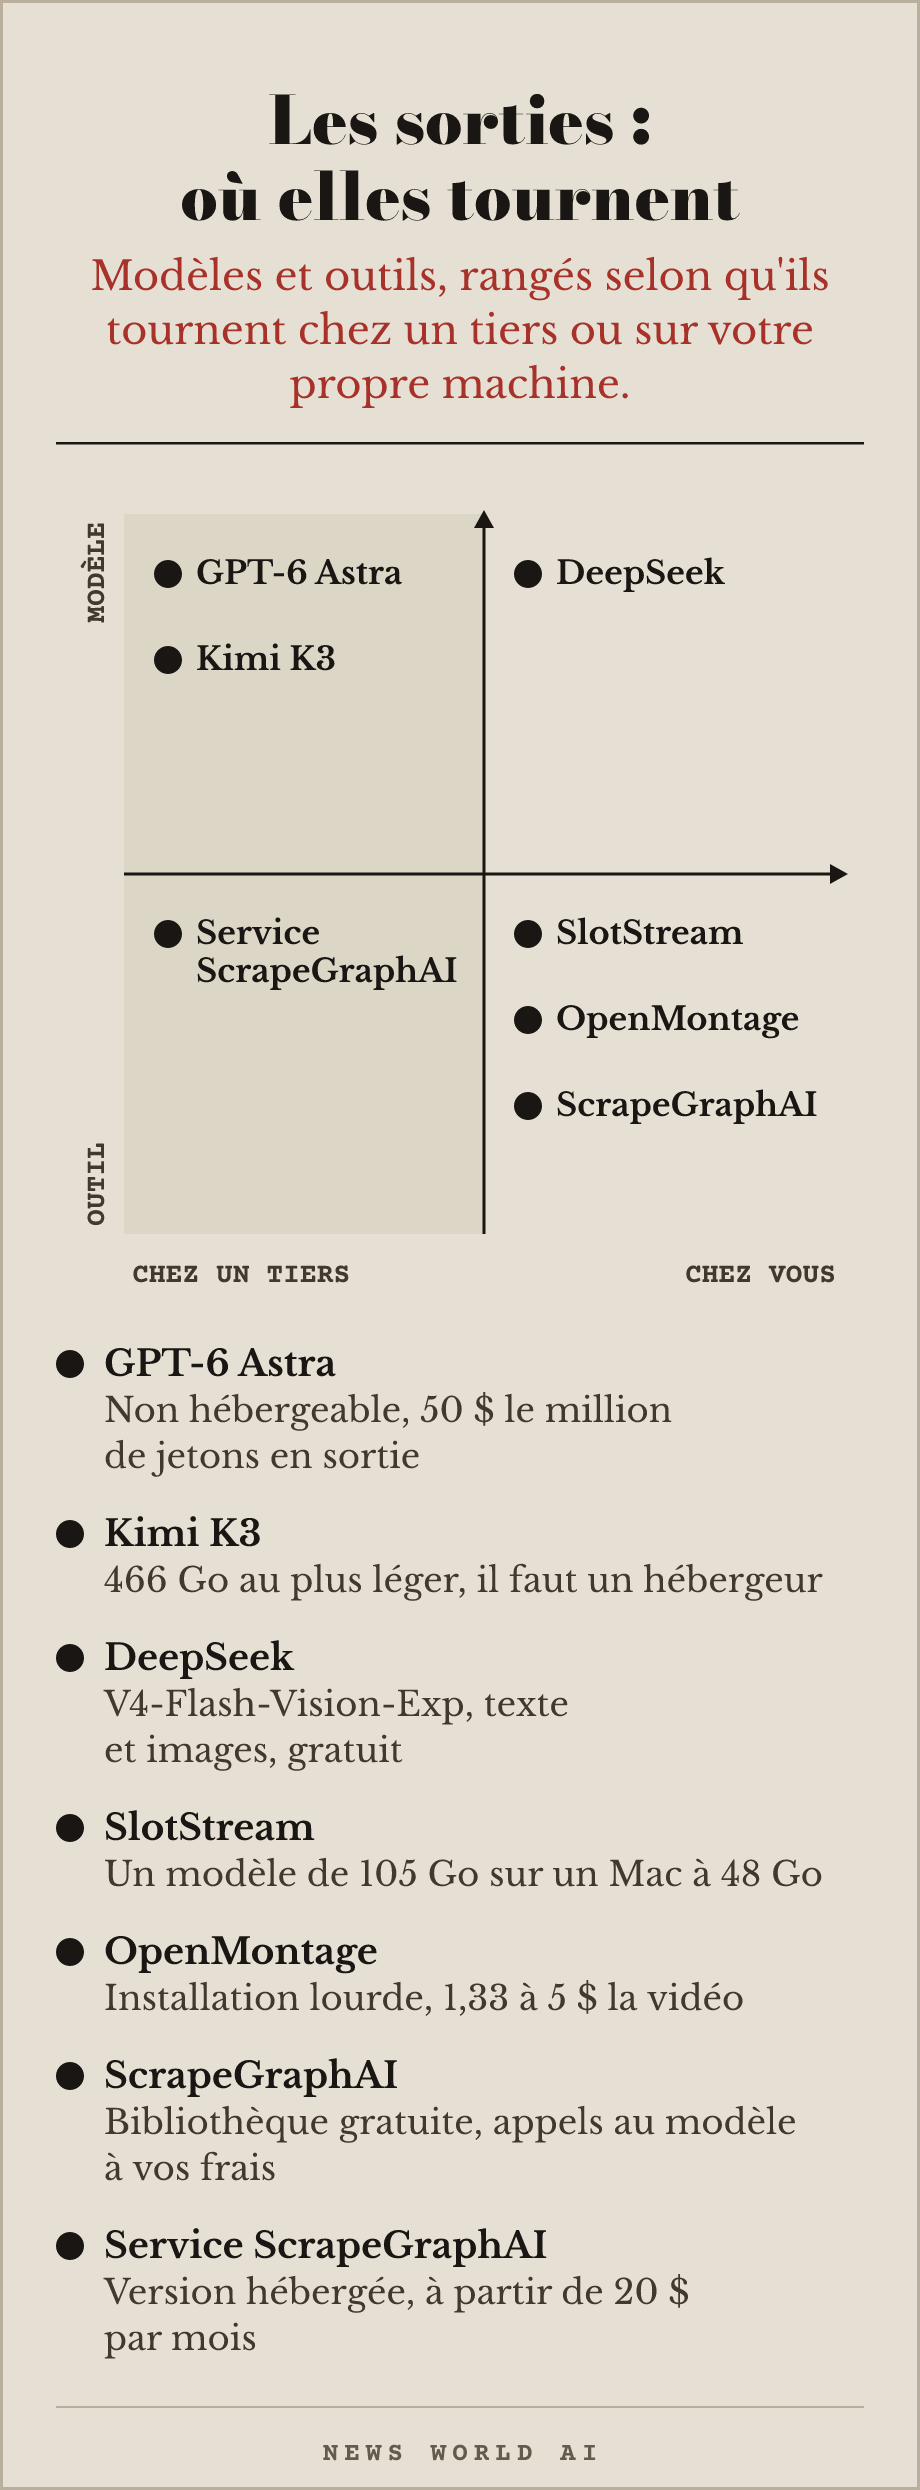
10 $ par million de jetons en entrée, 50 $ en sortie. Déploiement progressif sur ChatGPT Plus, Pro, Business, Enterprise et l'API OpenAI.
Pour quoi faire Programmation, cybersécurité, recherche scientifique, pilotage d'ordinateur. C'est le premier modèle à franchir le seuil « critique » du cadre de préparation d'OpenAI en cybersécurité, ce qui veut dire qu'il sait attaquer autant que défendre. Un mode rapide double la vitesse, et double le prix.
Limite Le déploiement n'est pas terminé, tout le monde ne l'a pas encore. Et c'est un modèle que vous ne pouvez pas héberger : la sortie est à 50 $ le million de jetons, quand la gamme Flash de Google est à 3,75 $.
Gemini 3.8 Flash (et Cyber)
Le dernier modèle Flash de Google, orienté agents, raisonnement et cybersécurité.
Pour quoi faire Faire tourner des agents et du raisonnement au coût le plus bas de la gamme Google. La variante Cyber est réservée aux équipes de défense invitées par Google.
Limite Flash Cyber n'est pas accessible au public, il est réservé à des équipes de défense. Le prix n'est publié nulle part sur la page d'annonce.
DeepSeek-V4-Flash-Vision-Exp
184 542 téléchargements, 695 mentions j'aime sur Hugging Face. Licence MIT.
Pour quoi faire Lire du texte et des images, gratuitement, avec des poids que vous hébergez vous-même. Utile pour alimenter un agent qui doit comprendre des captures d'écran ou des documents scannés.
Limite Version expérimentale (le nom le dit). Pas de papier technique repéré.
SlotStream
227 points et 114 commentaires sur Hacker News, premier sur Show HN le 1er septembre 2026. Open source, licence MIT.
Pour quoi faire Faire tourner un gros modèle (Qwen3.8-Flash-Next, 105 Go) sur un Mac à 48 Go de mémoire, à environ 12 jetons par seconde, sans rien envoyer à l'extérieur.
Limite Limité à macOS avec mémoire unifiée suffisante. 12 jetons par seconde, c'est utilisable pour poser des questions, pas pour traiter du volume.
OpenMontage
56 292 étoiles, 7 065 forks sur GitHub. Licence AGPL-3.0 (copyleft fort : si vous exposez un service basé dessus sur le réseau, vous devez publier vos modifications). Aucune version officielle publiée.
Pour quoi faire Vous décrivez la vidéo voulue, l'outil enchaîne seul la recherche, le script, les images, la voix, la musique, le montage et le rendu. 12 pipelines disponibles, dont Clip Factory, qui découpe une longue vidéo en une série de clips courts classés. Les démos du projet sont chiffrées entre 1,33 $ et 5 $ la vidéo, avec un plafond par défaut à 10 $.
Limite Installation lourde (Python, Node, Remotion). Pas de version prête à lancer.
Attention au sosie. Le dépôt OpenMontage-app/OpenMontage (1 étoile, créé le 27 août 2026) recopie mot pour mot la description du vrai projet sans en être un fork, et remplace l'AGPL par une licence MIT. Ne pas confondre.
ScrapeGraphAI
30 601 étoiles, 3 057 forks sur GitHub. Version 2.2.2, licence MIT. Python 3.12 minimum.
Pour quoi faire Vous donnez l'adresse d'une page et une phrase décrivant ce que vous voulez en tirer. Un modèle lit la page et rend les données rangées. La bibliothèque est gratuite, les appels au modèle restent à votre charge. Le service hébergé démarre à 20 $ par mois.
Limite Ne lit ni les flux RSS ni X. Le rendu des pages en JavaScript est à votre charge (Playwright à installer). Les sources gérées sont les sites web et les documents locaux.
Kimi K3
2 552 594 téléchargements, 11 209 mentions j'aime sur Hugging Face. 8 710 étoiles sur GitHub. Licence maison « Kimi K3 », poids ouverts sous conditions (au-delà de 20 millions de dollars de revenus en revendant de l'inférence, il faut un accord avec Moonshot AI).
Pour quoi faire Comprendre du texte et des images, et avaler d'un coup une fenêtre de 1 048 576 jetons, soit à peu près trois quarts de million de mots. Utile pour résumer de très gros documents ou alimenter un agent qui doit lire beaucoup. Le texte se lit désormais avec llama.cpp.
Limite Il n'est pas fait pour tourner chez vous. Le plus petit fichier allégé disponible pèse 466 Go, les autres montent à 594, 861 et 1 509 Go. La vision n'est pas encore gérée par llama.cpp, seul le texte l'est.
huggingface.co/moonshotai/Kimi-K3
Numéro 000 · Votre agent réussit une fois sur trois
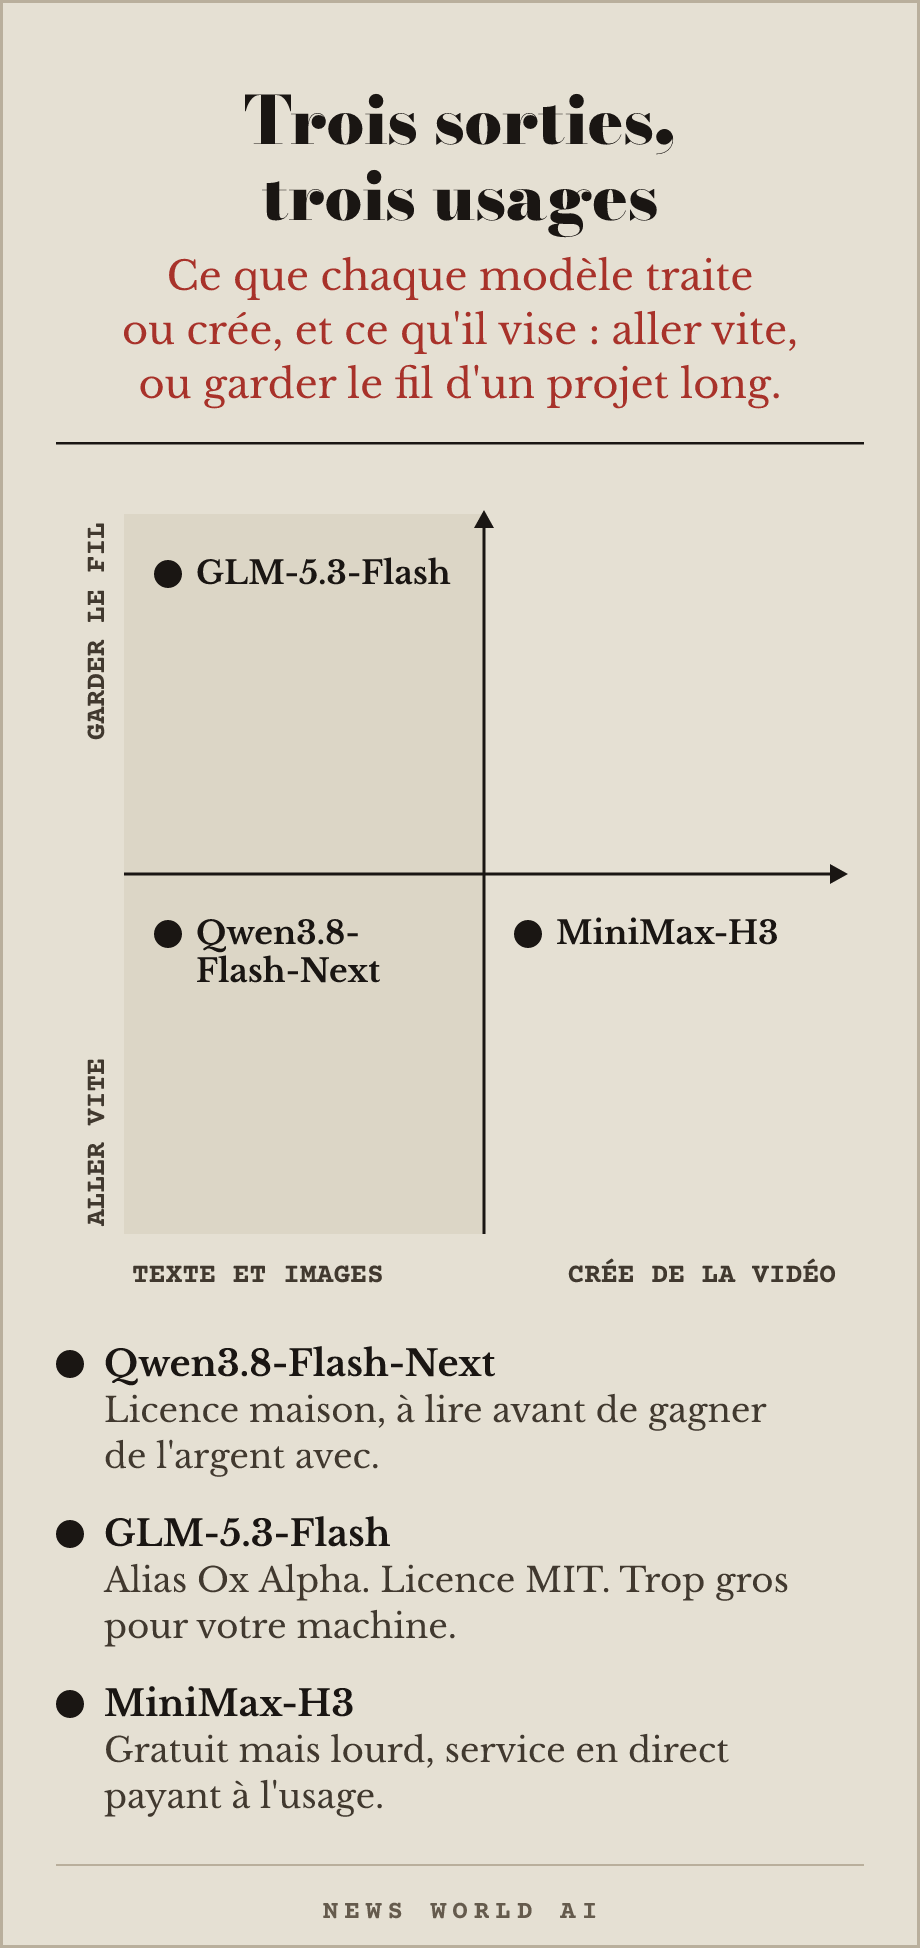
Qwen3.8-Flash-Next
Pour quoi faire les tâches répétées mille fois par jour, où chaque seconde et chaque centime comptent, et la lecture d'images en même temps que du texte.
Les compteurs 208 000 téléchargements, 4 580 mentions j'aime, plus 431 000 téléchargements de la version allégée.
La limite la licence est maison, pas Apache : à lire avant de gagner de l'argent avec. Pas de génération d'image.
→ huggingface.co/Qwen/Qwen3.8-Flash-Next, et unsloth/Qwen3.8-Flash-Next-GGUF pour la version qui tourne sur votre ordinateur, sans rien envoyer dehors.
GLM-5.3-Flash, alias Ox Alpha
L'histoire de la semaine. Un modèle sans nom d'éditeur apparaît sur OpenRouter, gratuit, sous le pseudonyme Ox Alpha, et se met à battre les meilleurs sur les classements. Enquête publique, analyses de tokenizer, paris en ligne. Puis le laboratoire chinois
Z.ai le confirme lui-même : c'était son GLM-5.3-Flash, mis là en test grandeur nature pour récolter des usages réels avant l'annonce. Les poids sont maintenant téléchargeables.
Pour quoi faire mener un projet long en gardant le fil, avec du texte et des images mélangés. Architecture éparse, 320 milliards de paramètres dont 18 seulement travaillent à chaque mot : c'est ce qui le rend bon marché à faire tourner.
Les compteurs 441 348 téléchargements le mois dernier, 1 930 mentions j'aime,
licence MIT, 300 000 mots de contexte.
La limite personne ne l'a testé de façon indépendante depuis qu'il a été démasqué, et il est bien trop gros pour tourner sur votre ordinateur : il faut passer par un service en ligne.
→ huggingface.co/zai-org/GLM-5.3-Flash, et l'annonce de Z.ai qui lève le pseudonyme.
MiniMax-H3, la vidéo plus rapide que le temps réel
Pour quoi faire fabriquer une vidéo à partir d'un texte ou d'une image, sans attendre.
Les compteurs 5,5 millions de téléchargements pour les poids ouverts.
La limite le modèle est gratuit mais lourd, et le service qui le fait tourner en direct est payant à l'usage.
Les archives reproduisent chaque numéro tel qu'il est parti, sans le réécrire. Les étoiles d'un dépôt, les prix et les dates de dernier commit sont ceux du jour de la vérification, pas ceux d'aujourd'hui : suivez le lien pour l'état courant.
Genève, Suisse. Écrire à hello@newsworldai.xyz.