News World
Les repos
Les dépôts GitHub sur lesquels s'appuyer, avec leurs étoiles, leur licence, leur dernier commit au jour de la vérification, et ce qu'ils ne couvrent pas.
Rien pour cette recherche dans les numéros parus.
Les repos
Numéro 009 · deepseek v4.1 flash revient, sous licence mit
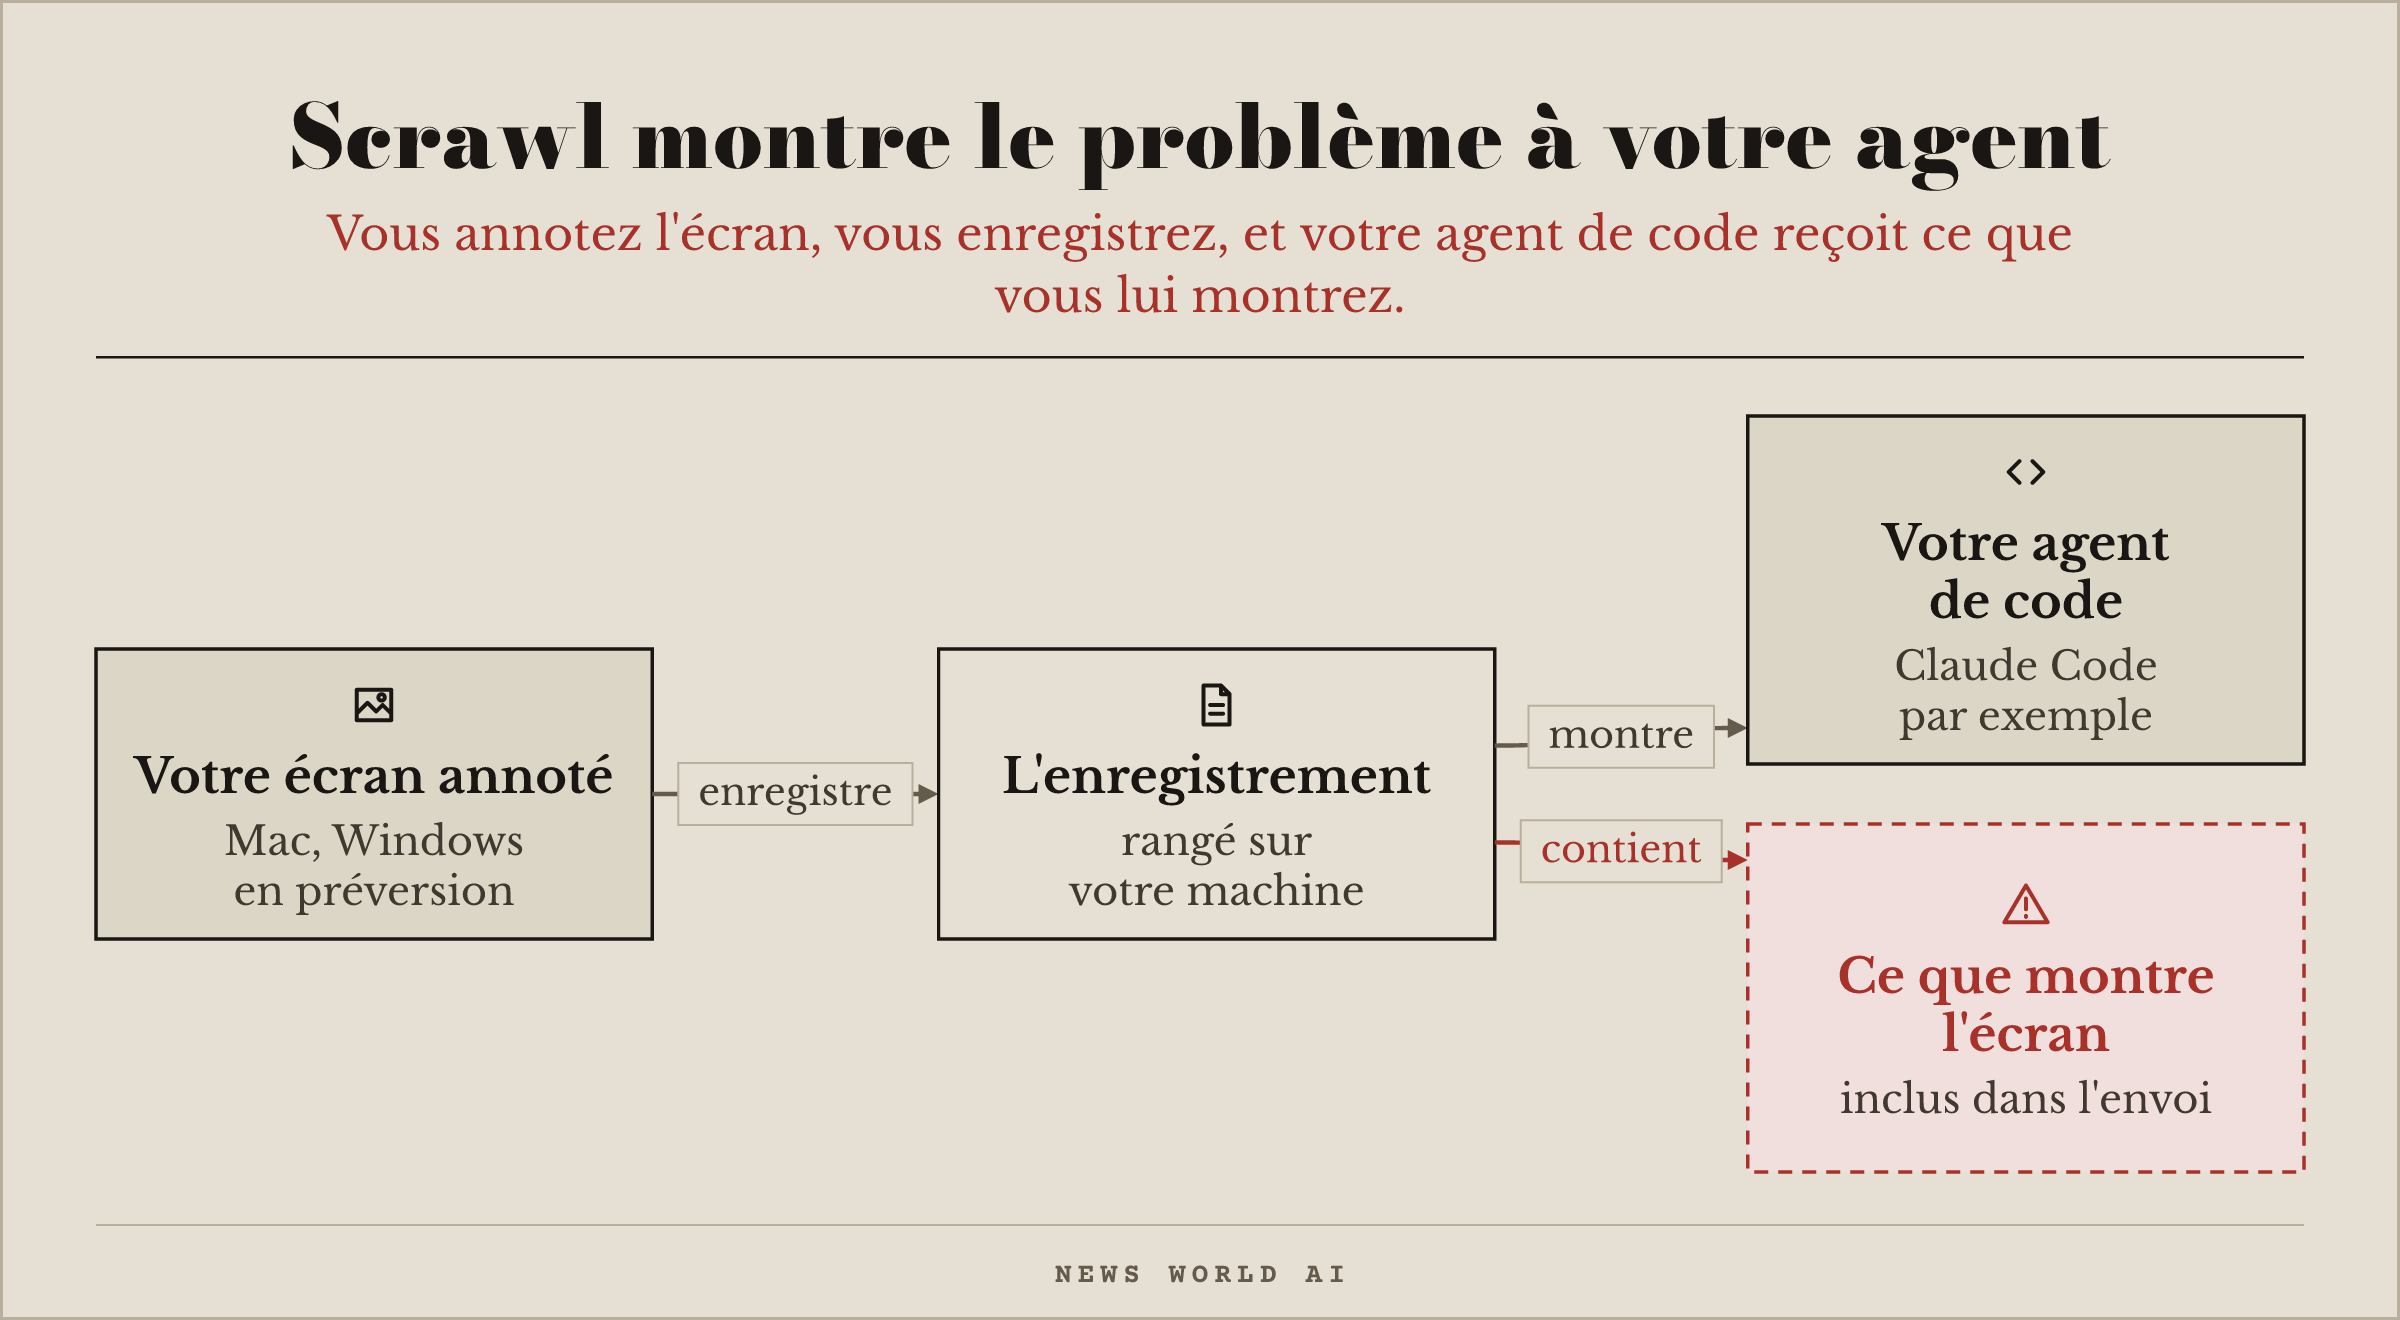
kitlangton/scrawl · ★ 546 · MIT · dernier commit 20 octobre 2026
Montrer un problème à votre agent au lieu de le décrire : vous annotez l'écran, vous enregistrez, vous envoyez. Il tourne sur Mac (Apple silicon, macOS 26), en préversion sur Windows, et il est présenté pour Claude Code et les autres agents de code. Les captures sont rangées dans un dossier de votre machine, et l'agent reçoit des images clés et un résumé (summary.md) qui porte la transcription, faite sur l'appareil, et la chronologie. Au 008, big-arrow-on-the-screen faisait l'inverse, l'agent dessinait des flèches pour vous ; scrawl ouvre l'autre sens du dialogue. Ce qu'il ne fait pas : il ne corrige rien, et il ne fournit aucun modèle qui réponde, seulement la transcription : c'est votre agent qui répond.
Graphicle-AI/graphicle · ★ 330 · Apache-2.0 · dernier commit 18 octobre 2026
Un plan du code et une mémoire pour vos agents de code, dans un seul programme, branché par MCP (le branchement standard des agents) sur Claude Code, Codex, Cursor ou tout autre client MCP. L'agent retrouve qui appelle quoi et ce qu'il a déjà appris du projet, et reçoit des extraits cités, avec le fichier et les lignes. La même semaine, Tencent publie Hy-Memory-30B-A3B, un modèle consacré à la mémoire. L'organisation qui publie graphicle n'a que trois semaines. Les notes que l'agent propose attendent votre accord, et un projet tient par défaut jusqu'à 100 000 fichiers texte et 1 Gio de texte. Ce qu'il ne fait pas : il ne donne pas la liste des langages qu'il lit.
eliasbiondo/antirion · ★ 134 · Apache-2.0 · dernier commit 18 octobre 2026
Un projet de trois jours : une passerelle d'IA open source, un seul programme avec sa console : tous vos appels de modèles (OpenAI, Anthropic, Gemini, Bedrock et d'autres) passent par elle, qui les aiguille, les surveille et leur fixe un budget. Au 007, notre problème était le plafond de dépense qui coupe vraiment : antirion le pose à un seul endroit pour tous les fournisseurs, et vos clés ne sont plus semées dans chaque outil. Ce qu'il ne fait pas : il n'a pas de version hébergée, il faut l'installer et l'entretenir vous-même, et il n'a pas de mesure indépendante de sa vitesse : le surcoût médian de 0,53 ms contre 19,7 ms pour Bifrost, à 5 000 requêtes par seconde, vient du banc d'essai du projet.
strands-agents/harness-sdk · ★ 8 878 · Apache-2.0 · dernier commit 20 octobre 2026
Le projet établi de la rubrique : un kit pour bâtir et contrôler le harnais d'un agent, c'est-à-dire tout ce qui entoure le modèle (la boucle de travail, les outils, les règles), en Python et en TypeScript, avec n'importe quel modèle et n'importe quel fournisseur de serveurs. Au 007, la même organisation publiait Box, sa boîte pour agents. Début octobre, Google Research a publié Harness², un cadre qui améliore lui-même le harnais, le modèle restant inchangé. Ce qu'il ne fait pas : ce n'est pas une application prête, il faut écrire du code ou le faire écrire, et il n'a pas de service hébergé : il tourne dans votre propre programme.
Numéro 008 · la boîte pour agents arrive sous windows
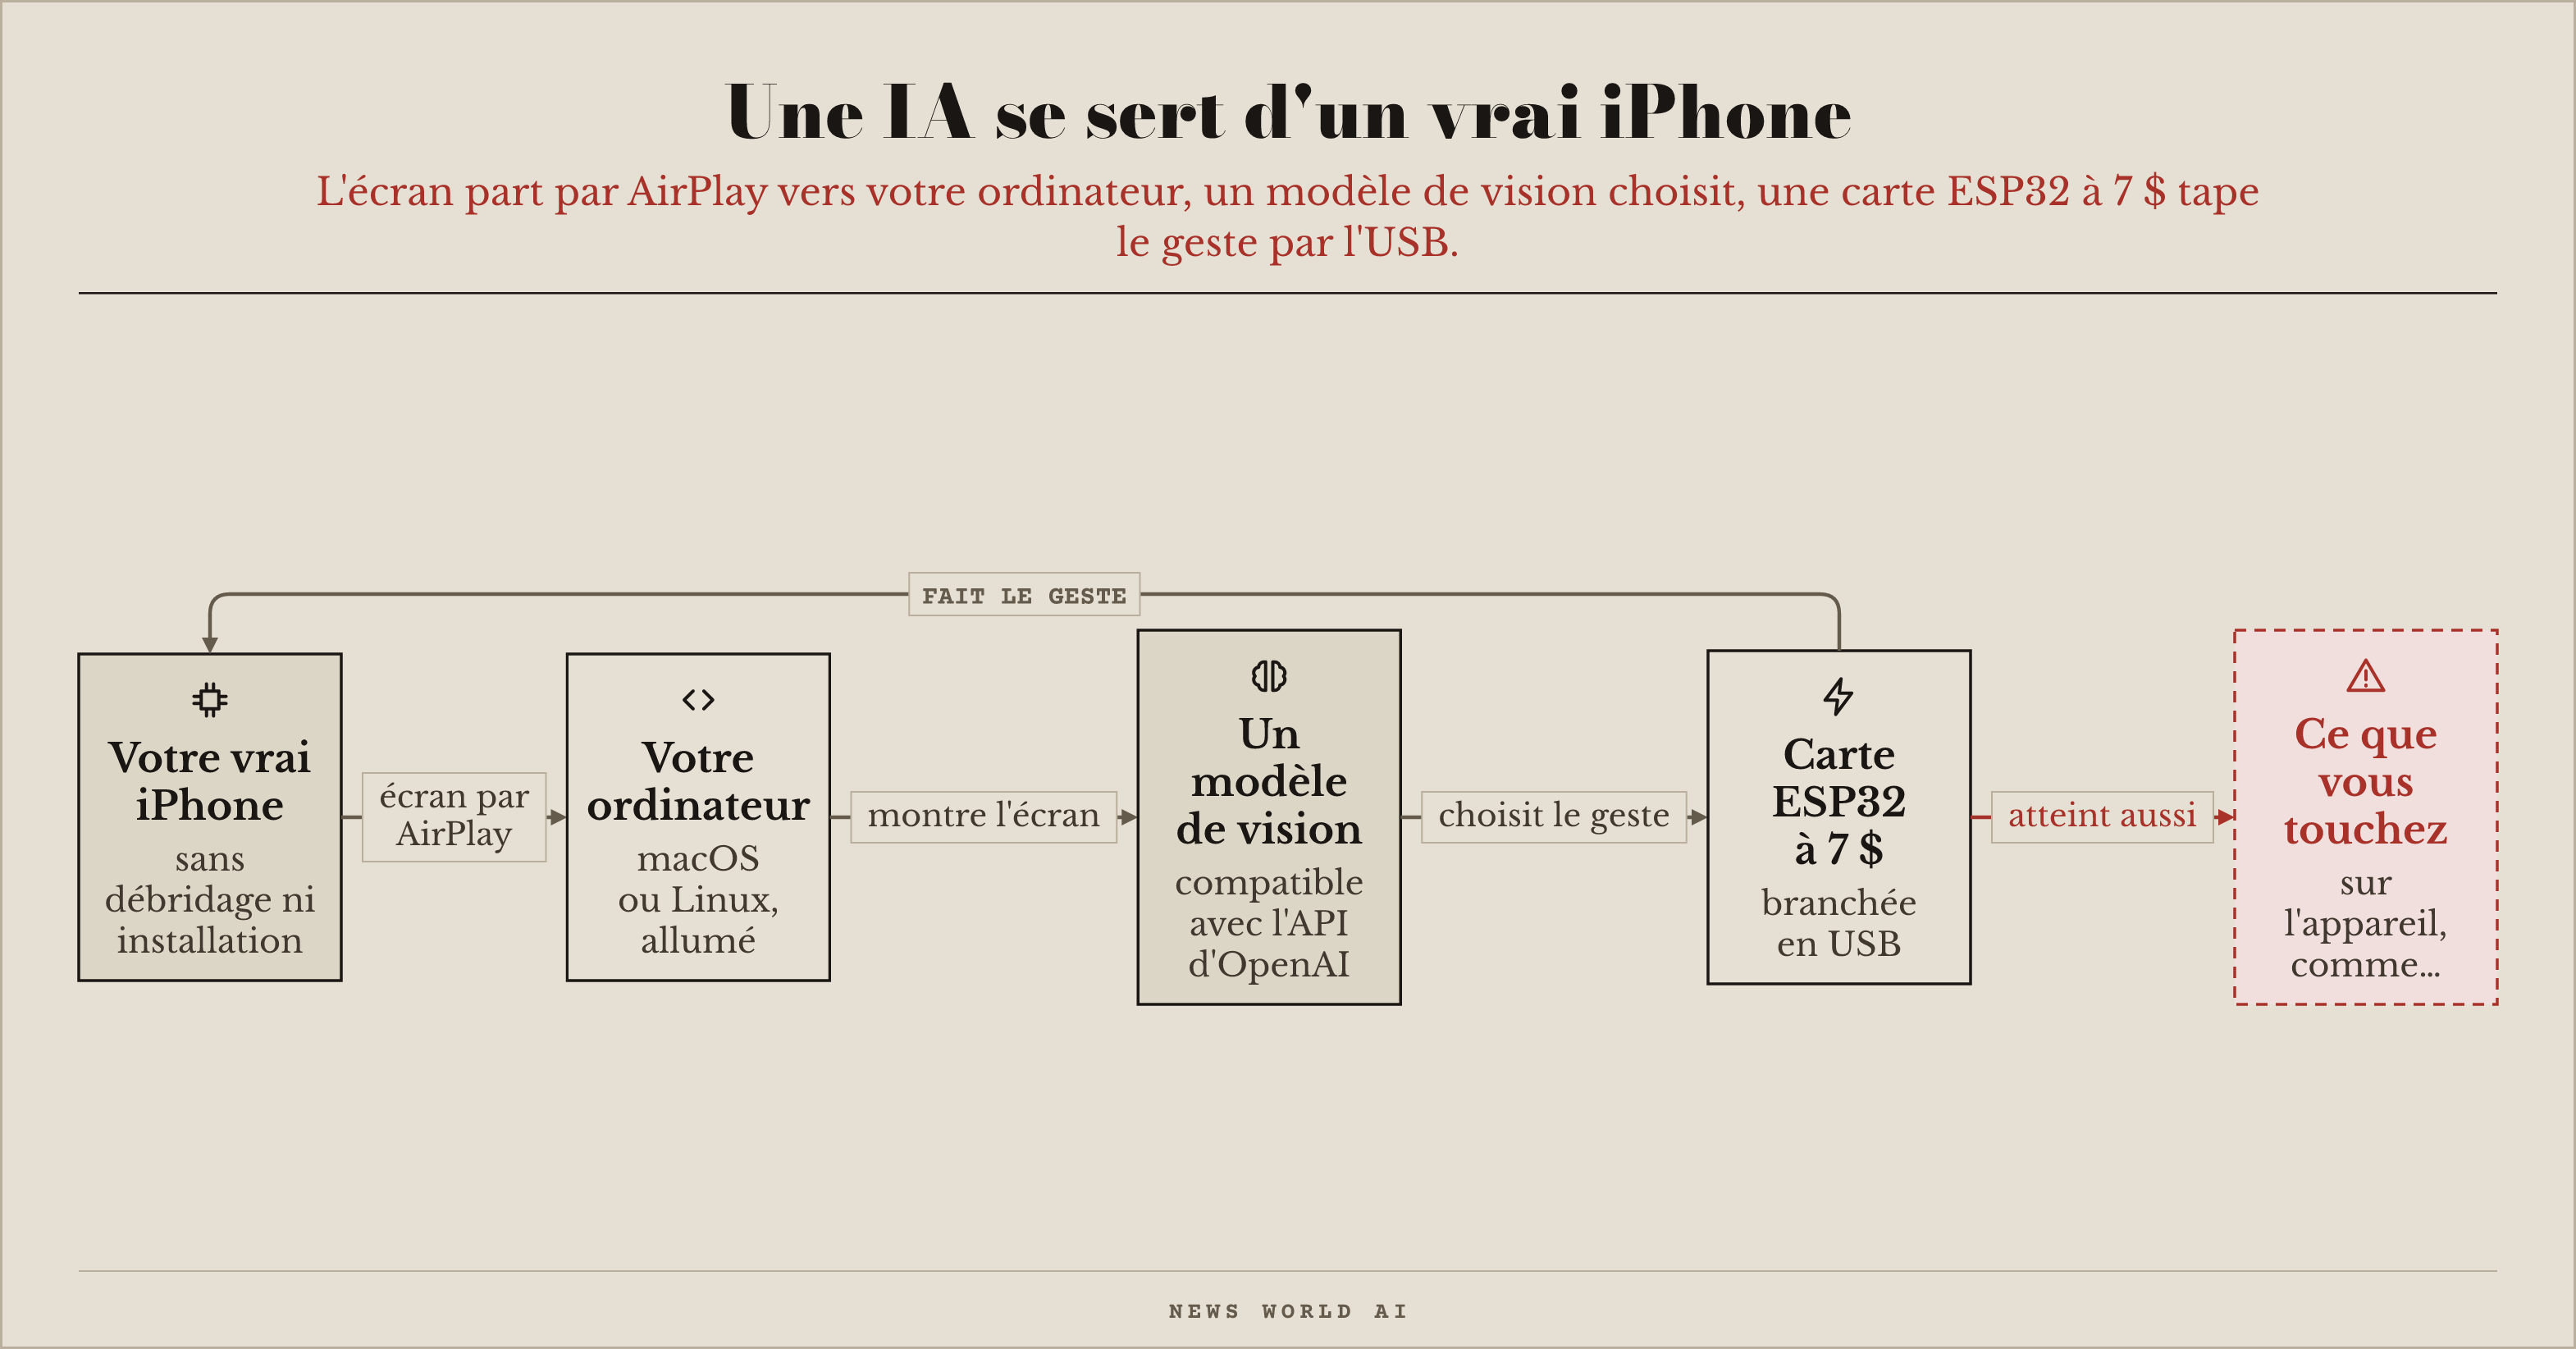
onehumanbeing/esp32-iphone-agent · ★ 1 411 · MIT · dernier commit 13 octobre 2026
Un modèle d'IA se sert d'un vrai iPhone grâce à une ESP32, une petite carte électronique à 7 $. L'écran part par AirPlay vers votre ordinateur, et la carte, branchée en USB, se présente au téléphone comme une souris et un clavier ordinaires : l'agent touche ce que vous touchez sur l'appareil (voir le réflexe sécurité). N'importe quel modèle de vision compatible avec l'API d'OpenAI choisit le geste suivant. Rien à installer sur le téléphone, pas de compte développeur ni de débridage. Ce qu'il ne fait pas : rien sans la carte, ni sans un ordinateur macOS ou Linux allumé sur le même réseau. L'agent ne voit ni la saisie du code, ni Apple Pay, ni les vidéos protégées. Aucune mesure de fiabilité n'est publiée.
bherbruck/solidcraft · ★ 1 609 · MIT ou Apache-2.0 · dernier commit 13 octobre 2026
Un logiciel de dessin de pièces en 3D où chaque pièce est cotée et se modifie en changeant une valeur (on parle de CAO paramétrique), open source et écrit en Rust (un langage de programmation) : application de bureau, version web, et pilotage par MCP, le branchement standard des agents, pour qu'un agent construise ou modifie une pièce à votre place. Il lit et écrit les fichiers courants de la fabrication et de l'impression 3D (STEP, IGES, 3MF, STL, OBJ). Créé le 7 octobre, il a passé les 1 500 étoiles en six jours et a été présenté sur Hacker News le 13 octobre (plus de 100 points). Au 000, text-to-cad changeait une description en fichier de conception, sans rien pour voir la pièce ; SolidCraft est l'application elle-même, avec l'agent branché dessus. Même mouvement chez blokkily, un logiciel de musique expérimental qui accepte MCP. Ce qu'il ne fait pas : il ne produit ni plans techniques en 2D ni instructions pour les machines de fabrication, deux chantiers reportés jusqu'à nouvel ordre selon sa feuille de route, et son dépôt ne le dit utilisable, pour l'instant, que pour des pièces simples.
franzenzenhofer/big-arrow-on-the-screen · ★ 689 · MIT · dernier commit 12 octobre 2026
Votre agent dessine de grosses flèches, des cadres et du texte sur l'écran de votre Mac pour vous montrer où cliquer : une seule commande, un calque que vos clics traversent, et qui disparaît tout seul. Il est livré comme compétence (un mode d'emploi que l'agent charge) pour Claude Code et Codex, et a fait 418 points et 196 commentaires sur Hacker News le 9 octobre. Pour qui construit sans être ingénieur, c'est l'agent qui montre au lieu de décrire, dans une interface qu'on ne connaît pas. Ce qu'il ne fait pas : il dessine, mais il ne clique pas, ne tape rien et ne capture pas l'écran. Mac seulement.
dagucloud/dagu · ★ 4 341 · GPL-3.0 · dernier commit 13 octobre 2026
Le projet établi de la rubrique : un programme à installer chez vous qui lance vos tâches à l'heure dite ou les unes après les autres. Vous décrivez dans un fichier texte de réglages (le format YAML) l'enchaînement de vos scripts et des commandes envoyées à d'autres machines ; un seul programme, sans base de données. Au 007, notre agent laissé seul la nuit : dagu est l'endroit d'où lancer cette tâche à heure fixe, à côté du plafond de dépense. Et quand les étapes sont connues d'avance, un enchaînement fixe coûte moins cher qu'un agent et refait la même chose à chaque fois. Sa licence GPL-3.0 oblige qui redistribue une version modifiée à en fournir le code source à ceux qui la reçoivent. Ce qu'il ne fait pas : il ne décide rien, il enchaîne ce que vous avez écrit. Il ne tourne que sur une machine à vous, allumée, et n'a pas de version hébergée qui exécute vos tâches : l'exécution reste sur vos serveurs.
Numéro 007 · des modèles de décision à télécharger
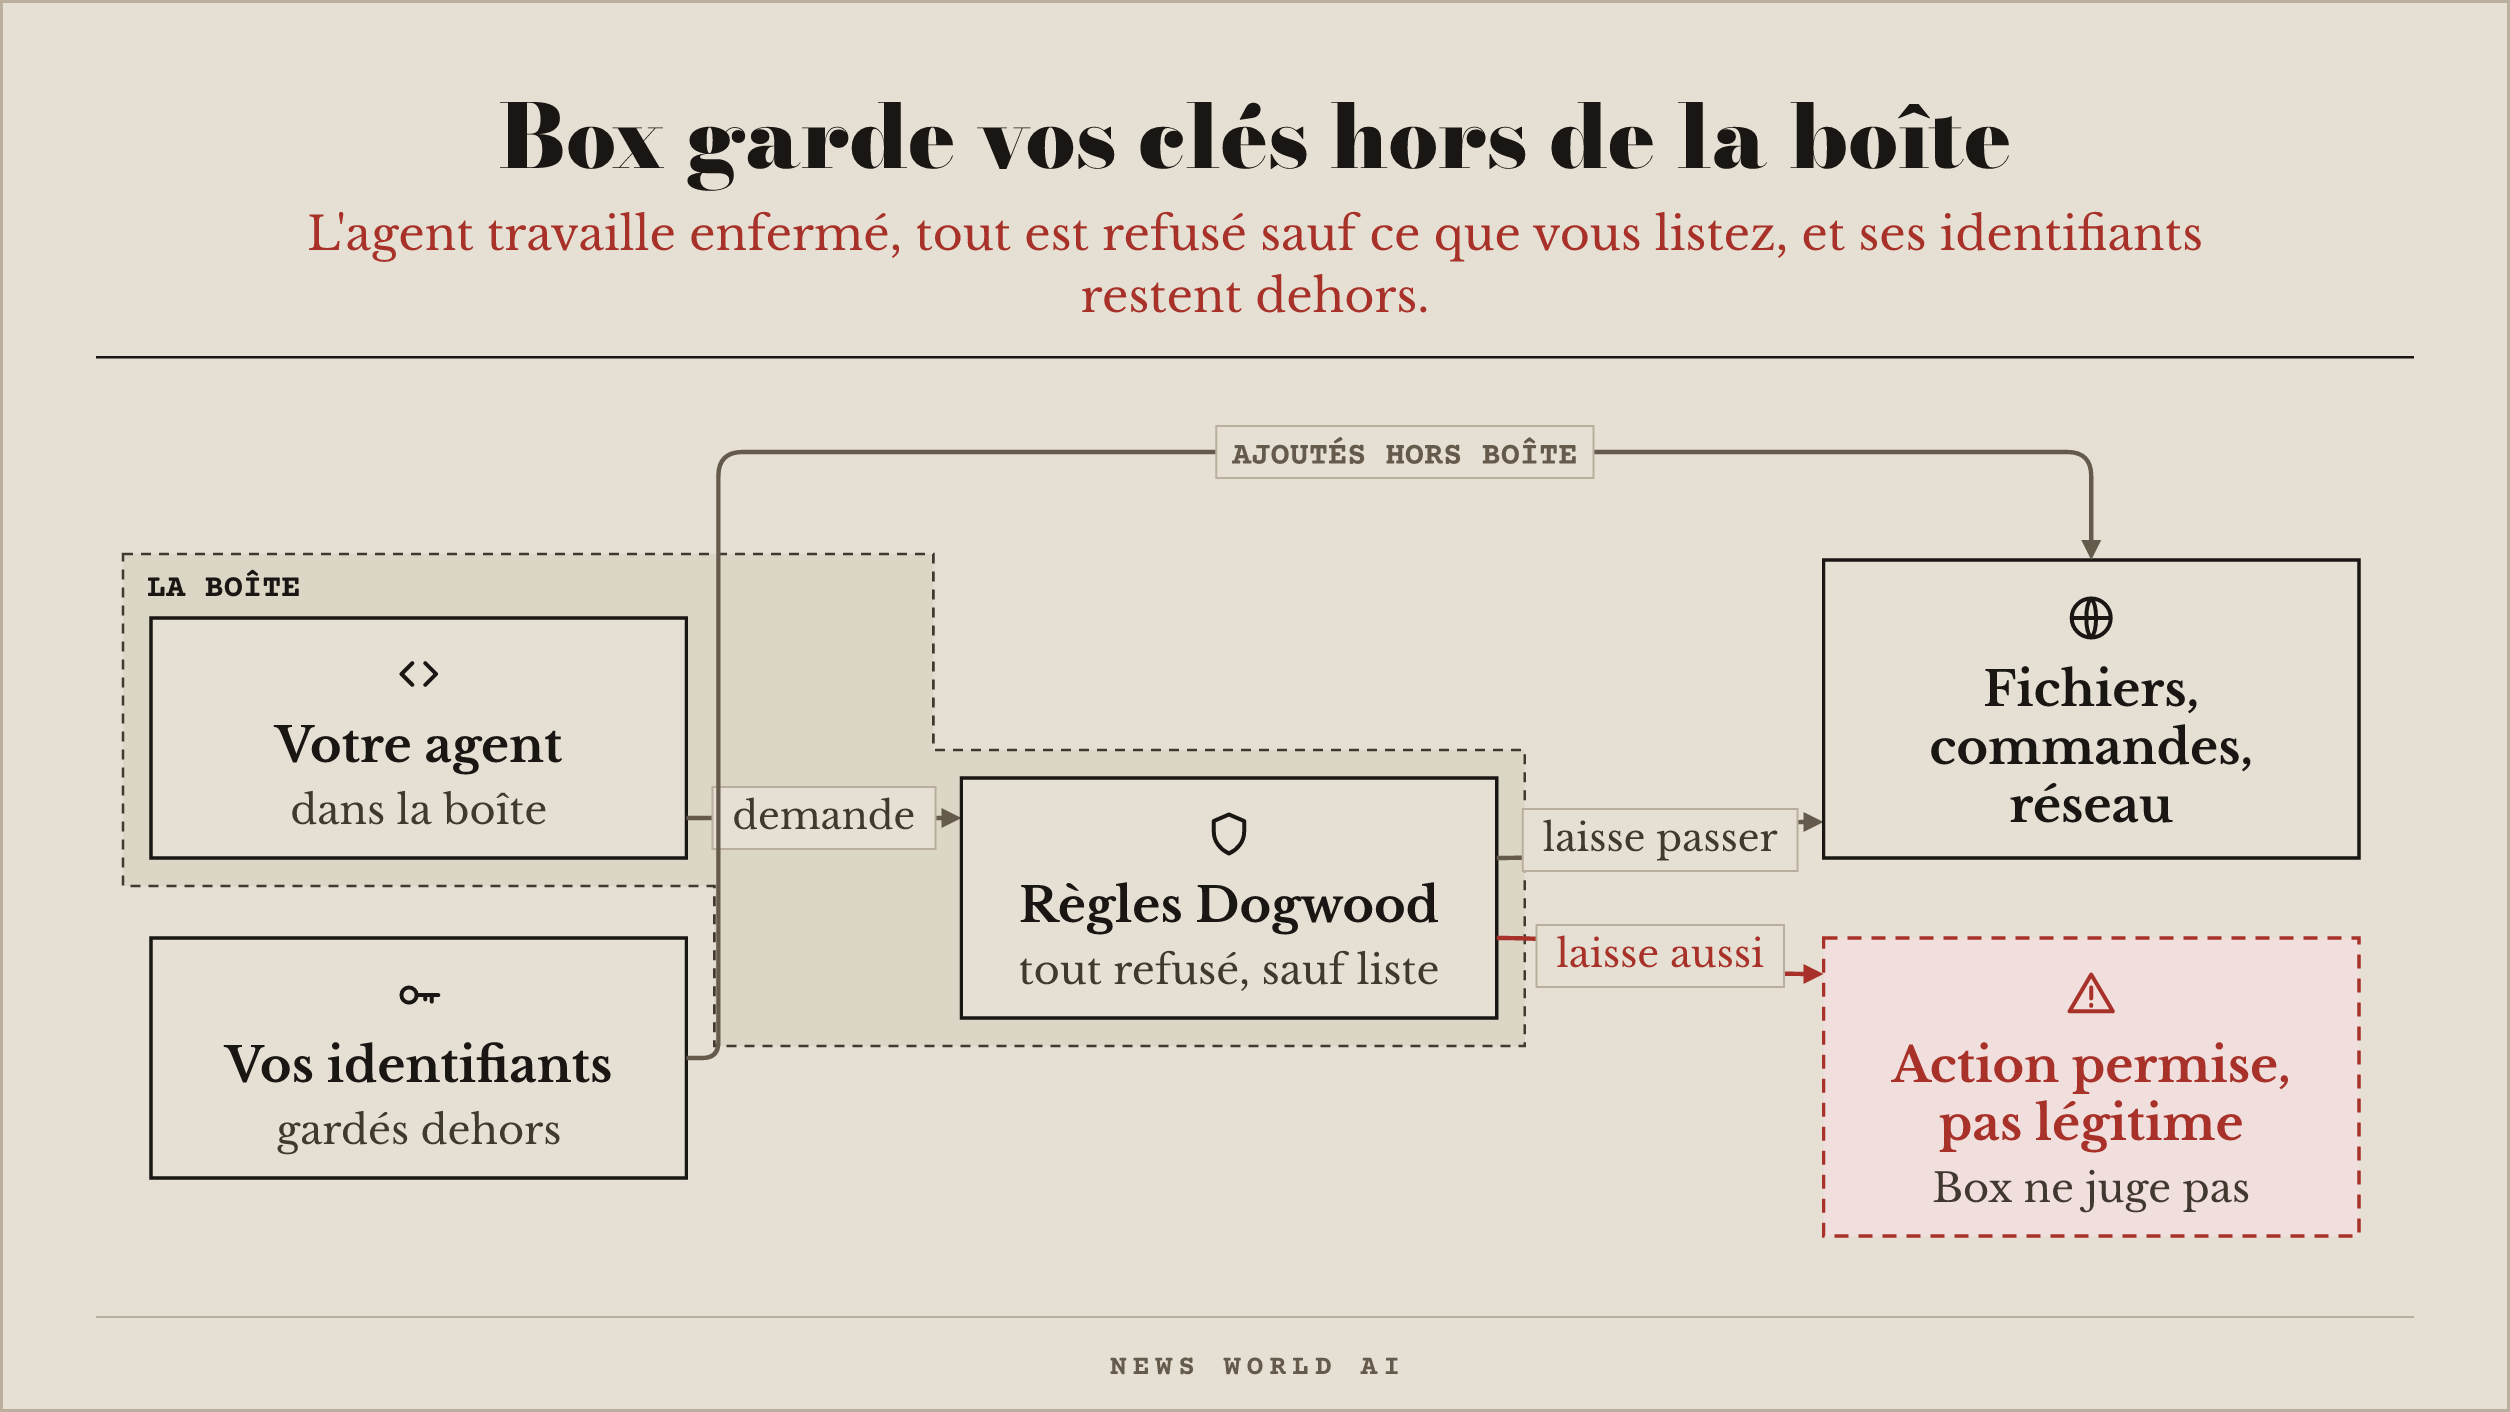
strands-agents/box · ★ 208 · Apache-2.0 · dernier commit 7 octobre 2026
Un bac à sable pour agents, publié par l'organisation du kit Strands Agents : il limite ce que l'agent peut lancer, lire, écrire et joindre sur le réseau. Ses règles, baptisées Dogwood, refusent tout par défaut, et Box fournit vos identifiants depuis l'extérieur : les secrets restent hors de la boîte. Au 006, notre problème de la semaine finissait sur « un agent enfermé avec vos clés peut toujours s'en servir » ; Box s'attaque à ce point. Ce qu'il ne fait pas : il n'écrit pas pour vous la liste de ce qui passe, et ne juge pas si une action autorisée est légitime. Il ne tourne ni sous Linux (prévu) ni sous Windows : seulement sur Mac à puce Apple, avec macOS 15 ou plus récent.
openqodex/openqodex · ★ 400 · Apache-2.0 · dernier commit 8 octobre 2026
Une relecture de code par IA avant d'envoyer vos changements, pour Claude Code et Codex, faite par Qodex, qui propose aussi une relecture hébergée de chaque demande de modification. Des analyseurs cherchent les failles connues, les secrets oubliés, les dépendances à risque et les fautes de style sur les seules lignes modifiées, puis un second programme, séparé, vérifie chaque alerte avant de vous la montrer. OpenAI propose la même fonction avec codex-security (11 029 étoiles, Apache-2.0), et GitHub publie un banc d'essai pour comparer ces relecteurs (voir En bref). Ce qu'il ne fait pas : il ne regarde que les lignes changées, pas une faille plus ancienne ailleurs dans le code, et il ne garantit pas de tout trouver. Il n'a publié aucun score sur ce banc d'essai.
toby-bridges/api-relay-audit · ★ 872 · AGPL-3.0 · dernier commit 8 octobre 2026
Vous passez par un relais qui revend moins cher l'accès à Claude ou à GPT ? Cet outil l'audite depuis votre machine : consignes glissées dans vos requêtes, modèle remplacé par un autre (vous payez l'un, on vous sert l'autre), appels d'outils réécrits, réponses qui arrivent de travers, fuites dans les messages d'erreur. Au 006, nous mettions en garde contre un greffon qui promettait un modèle « gratuit et illimité » : voici de quoi tester ce genre d'intermédiaire avant de lui confier vos requêtes. Ce qu'il ne fait pas : il dit ce qu'il a vu au moment où on le lance, il ne surveille pas en continu, et un relais peut changer ensuite. Il ne rend pas un relais sûr. Il ne prouve pas qu'un modèle a été remplacé : l'identité que se donne le modèle, des phrases repères, le temps de réponse et des empreintes techniques sont des indices, pas une preuve à eux seuls, précise le dépôt.
Numéro 006 · deux réponses ouvertes à l'idée de jev
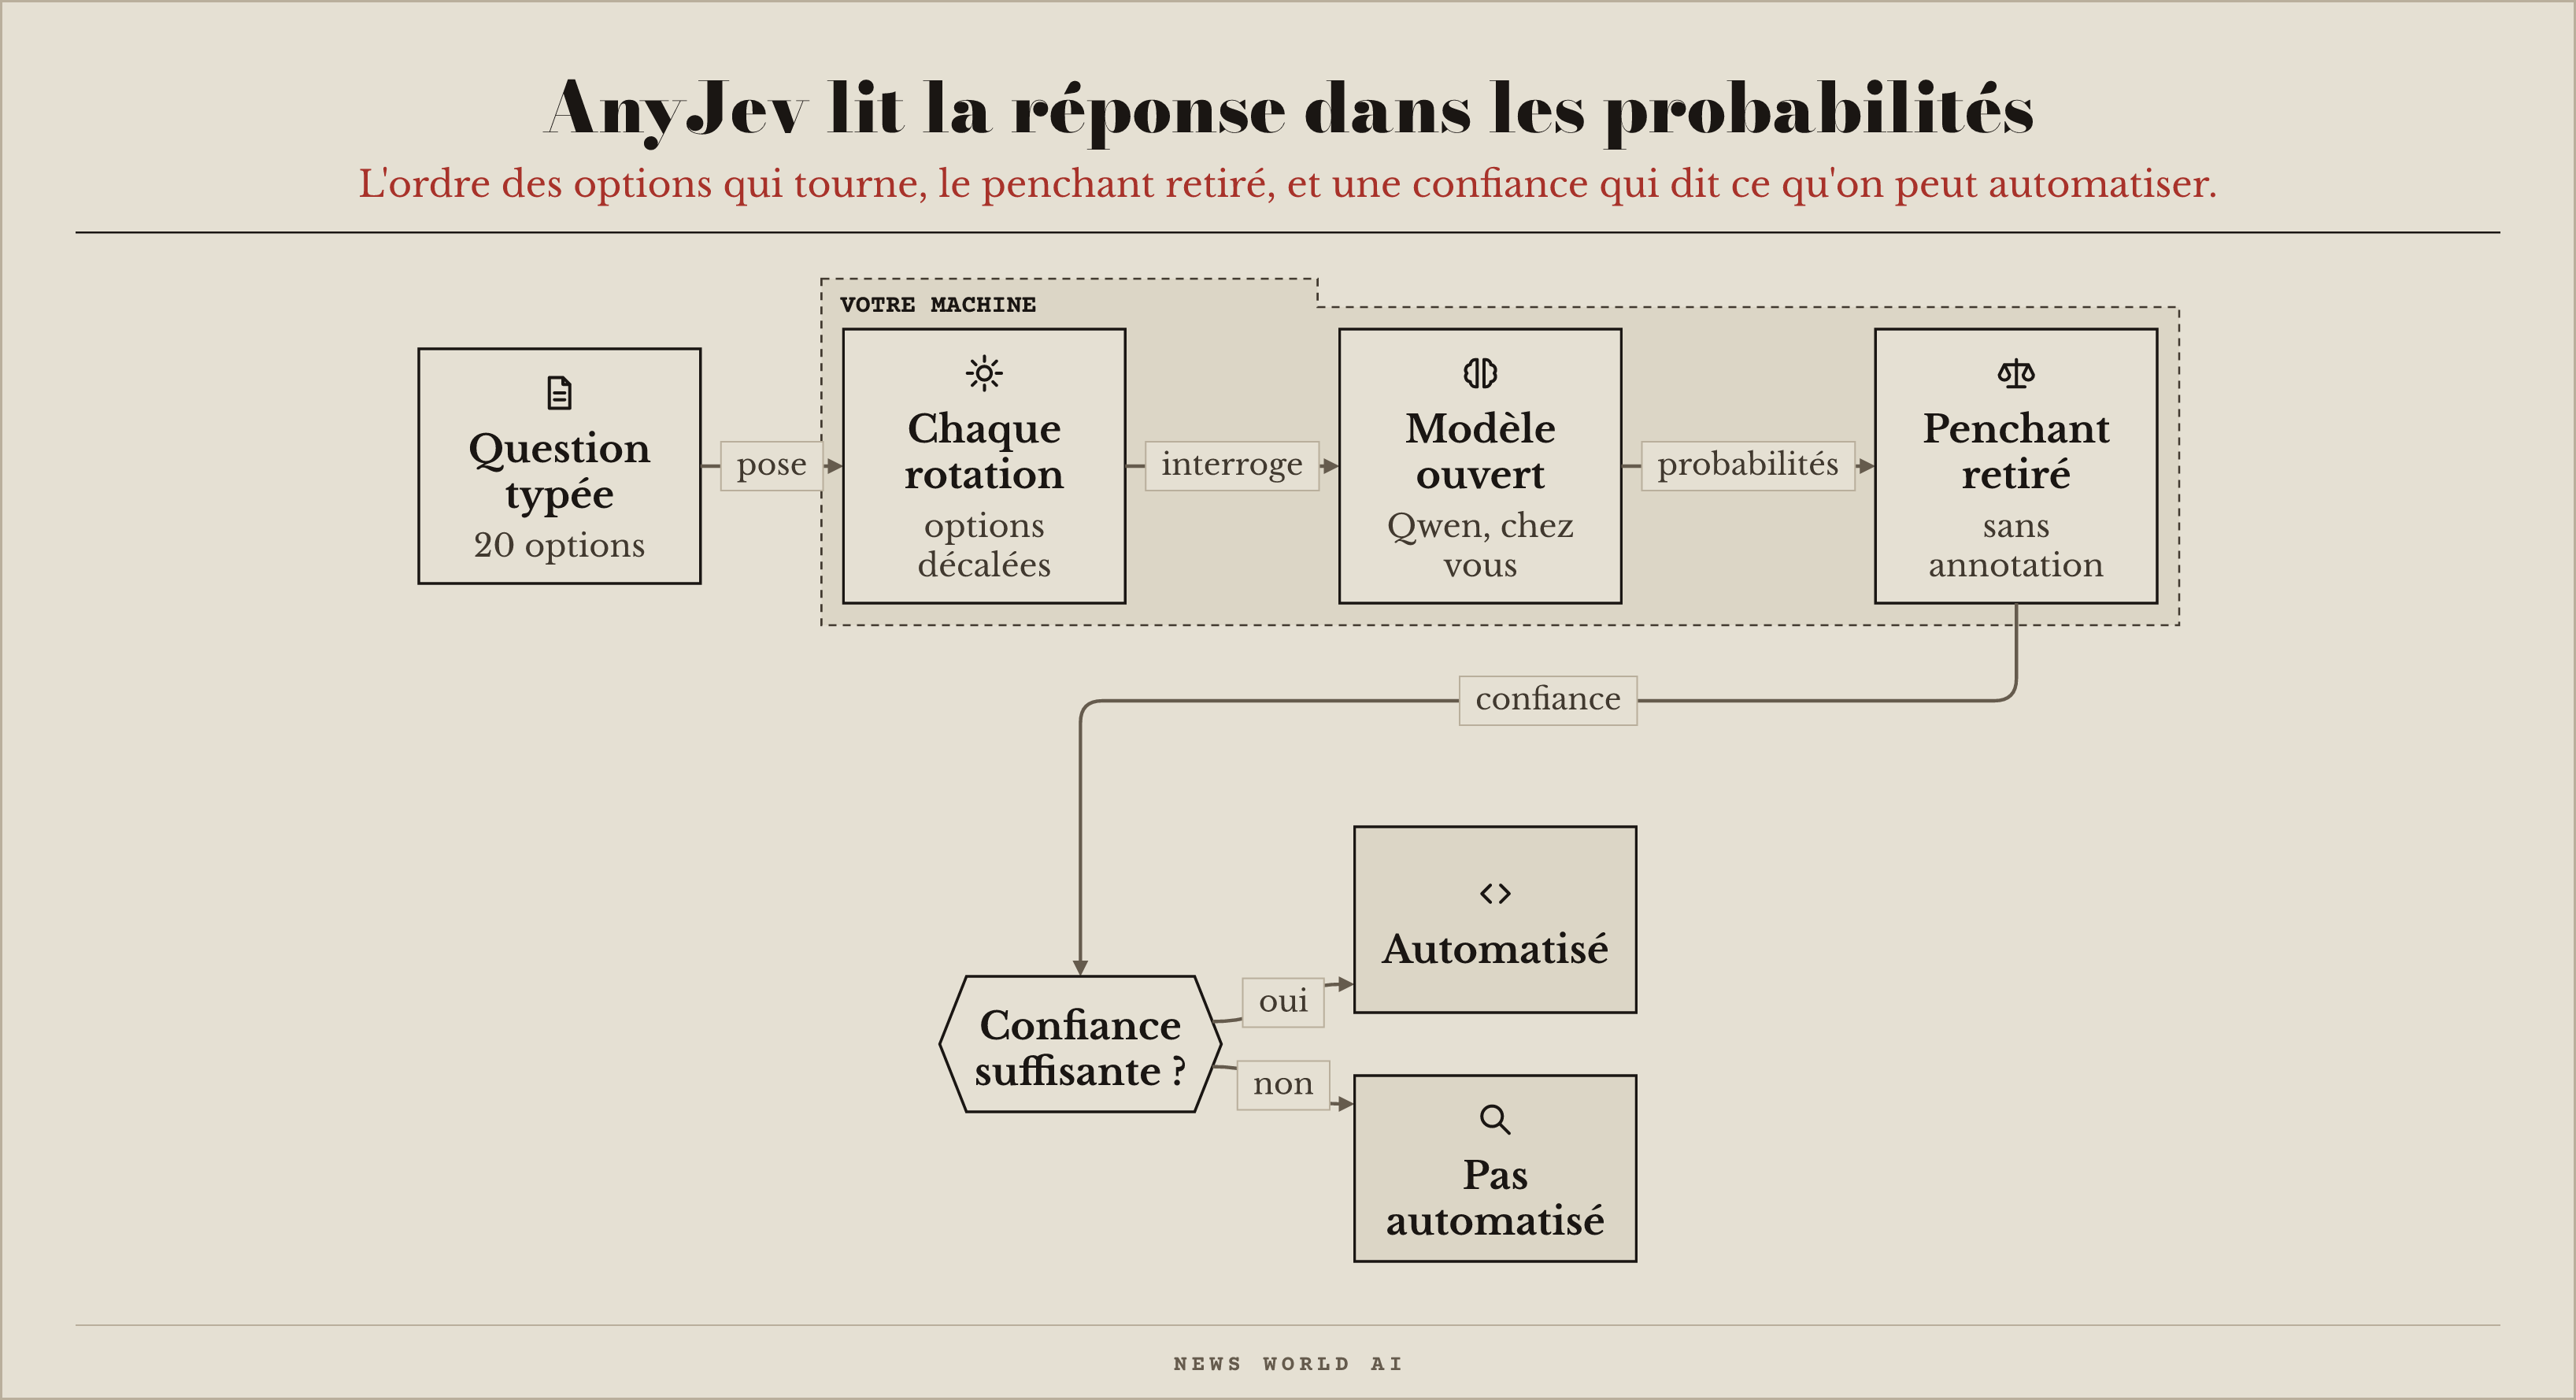
nokia-applied-research/AnyJev · ★ 894 · Apache-2.0 · dernier commit 28 septembre 2026
Une bibliothèque de recherche de Nokia (paquet anyjev 0.2.0 sur PyPI) qui pose à un modèle ouvert une question typée à la manière de Jev et lit sa réponse dans ses probabilités internes. Lue telle quelle, la réponse change quand on inverse l'ordre des options, et une confiance de 0,9 ne veut pas dire 90 %. AnyJev fait tourner l'ordre des options et retire le penchant du modèle pour certaines étiquettes, sans exemple annoté. Avec 100 à 500 exemples annotés, il ajuste aussi la confiance. Sur un tri de messages bancaires en 20 catégories, les auteurs mesurent que la part des cas qu'on peut automatiser avec au plus 5 % d'erreurs passe de 7,7 % à 46,3 % sans annotation : une mesure sur un seul modèle (Qwen3-8B) et 300 cas, qu'ils disent eux-mêmes très incertaine. Ce qu'il ne fait pas : il ne marche qu'avec un modèle ouvert qu'on fait tourner soi-même, jamais Claude, GPT ou Jev par leur interface. Il ne rend pas juste un modèle qui ne sait pas répondre, et son dépôt précise n'avoir aucun lien avec TypeSafe.
github.com/nokia-applied-research/…
La justesse ne bouge que de six points (74,7 %, 80,3 %, 80,7 %), mais la confiance devient fiable : c'est elle qui décide ce qu'on laisse partir sans relecture.
mikehasa/golive-skill · ★ 1 055 · MIT · dernier commit 29 septembre 2026
Une compétence d'agent et un petit outil en ligne de commande qui mettent en ligne ce que votre agent a construit : hébergement, base de données, nom de domaine, courriel, paiement, sur vos propres comptes, avec une étape d'approbation avant d'appliquer et une vérification après. Ce qu'il ne fait pas : il n'héberge rien et ne paie rien pour vous, les comptes et les factures restent les vôtres.
yetone/magpie · ★ 1 720 · MIT · dernier commit 29 septembre 2026
Vous choisissez quel modèle sert chaque agent de code : Codex sur DeepSeek, Claude Code sur Kimi. Il tourne sur macOS, Linux et Windows, avec une application dans la barre des menus. Ce qu'il ne fait pas : il ne fournit ni modèle ni clé, il faut vos propres abonnements.
Numéro 005 · jev coche une case, votre code décide
typesafe-ai/system-one-adapter-python · ★ 257 · MIT · dernier commit 22 septembre 2026
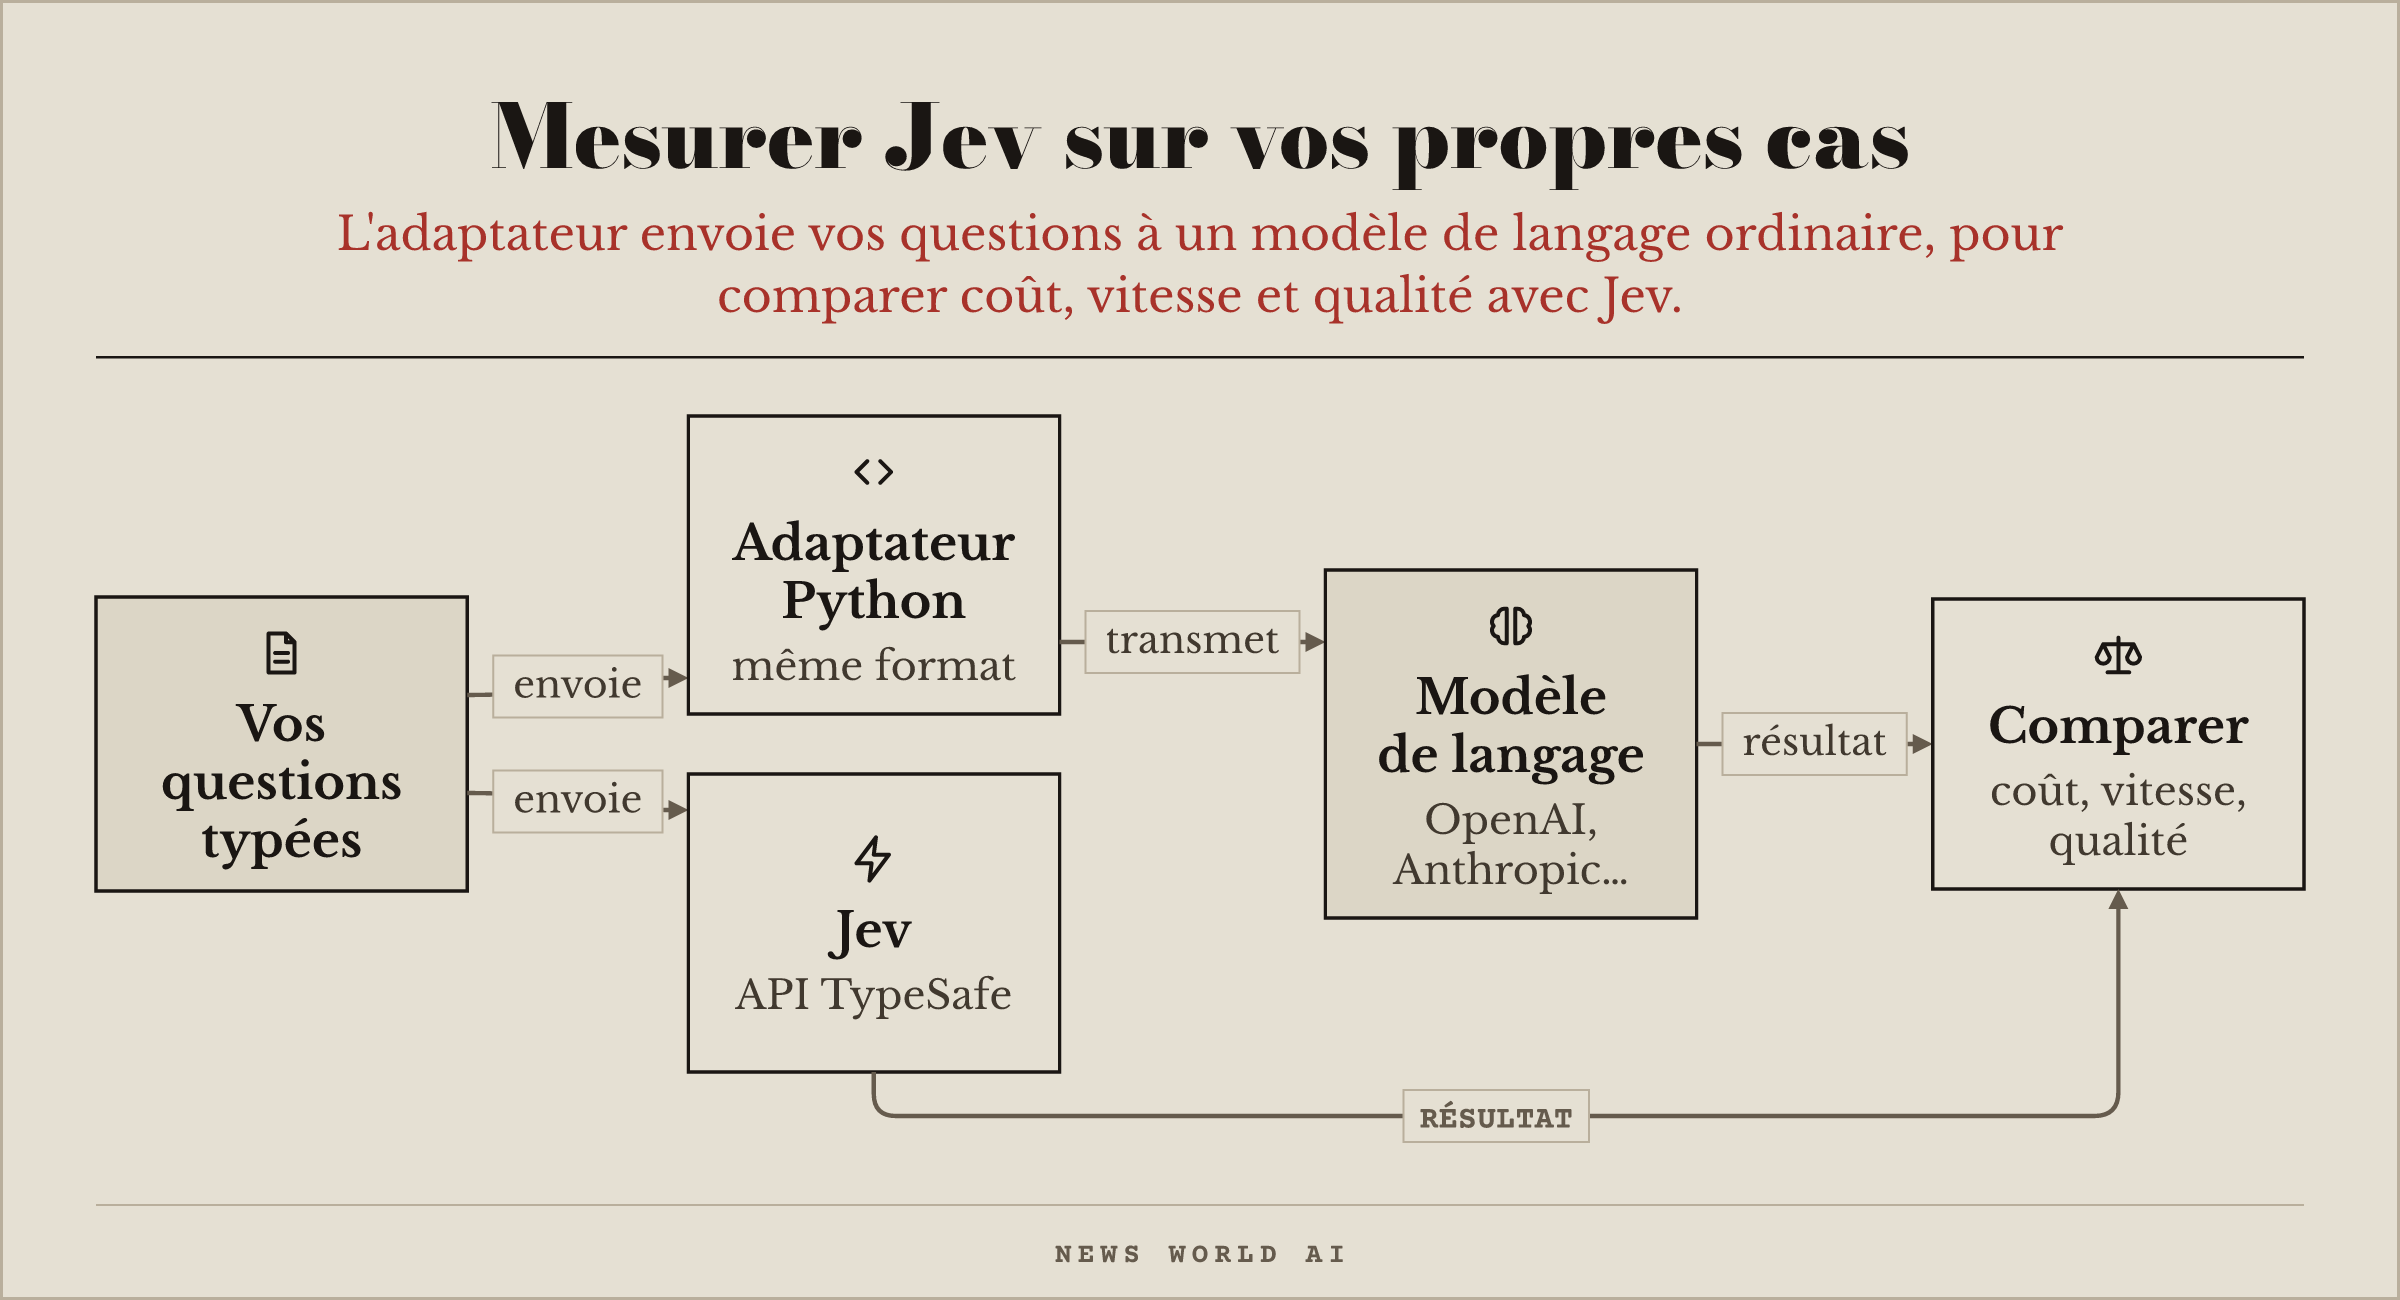
Fait répondre un modèle de langage ordinaire (OpenAI, Anthropic, Google Gemini ou tout service compatible avec OpenAI) aux mêmes questions typées que Jev. De quoi comparer coût, vitesse et qualité sur vos propres cas avant de croire les chiffres de l'éditeur. Ce qu'il ne fait pas : il ne donne pas accès à Jev, et il ne choisit pas les cas de test à votre place.
awlevin/typesafe-computer-use · ★ 814 · MIT · dernier commit 18 septembre 2026
Un agent pilote le bureau macOS : capture d'écran, choix de l'action suivante par Jev, clic. Coût annoncé : 0,0002 $ par étape. Ce qu'il ne fait pas : il ne tourne que sur macOS, ne voit que l'écran principal, ne lit que les boutons des applications qui les décrivent au système, et ne fonctionne pas sans l'API TypeSafe.
fujibee/agmsg · ★ 1 515 · MIT · dernier commit 22 septembre 2026
Messagerie entre agents de code : Claude Code, Codex, Gemini et Copilot échangent en ligne de commande, avec Bash et SQLite, sans service à installer. Ce qu'il ne fait pas : il ne passe pas par le réseau, les agents partagent un même fichier SQLite.
Numéro 004 · savoir ce que l'agent a fait
callstack/agent-device · ★ 4 585 · MIT · dernier commit 15 septembre 2026
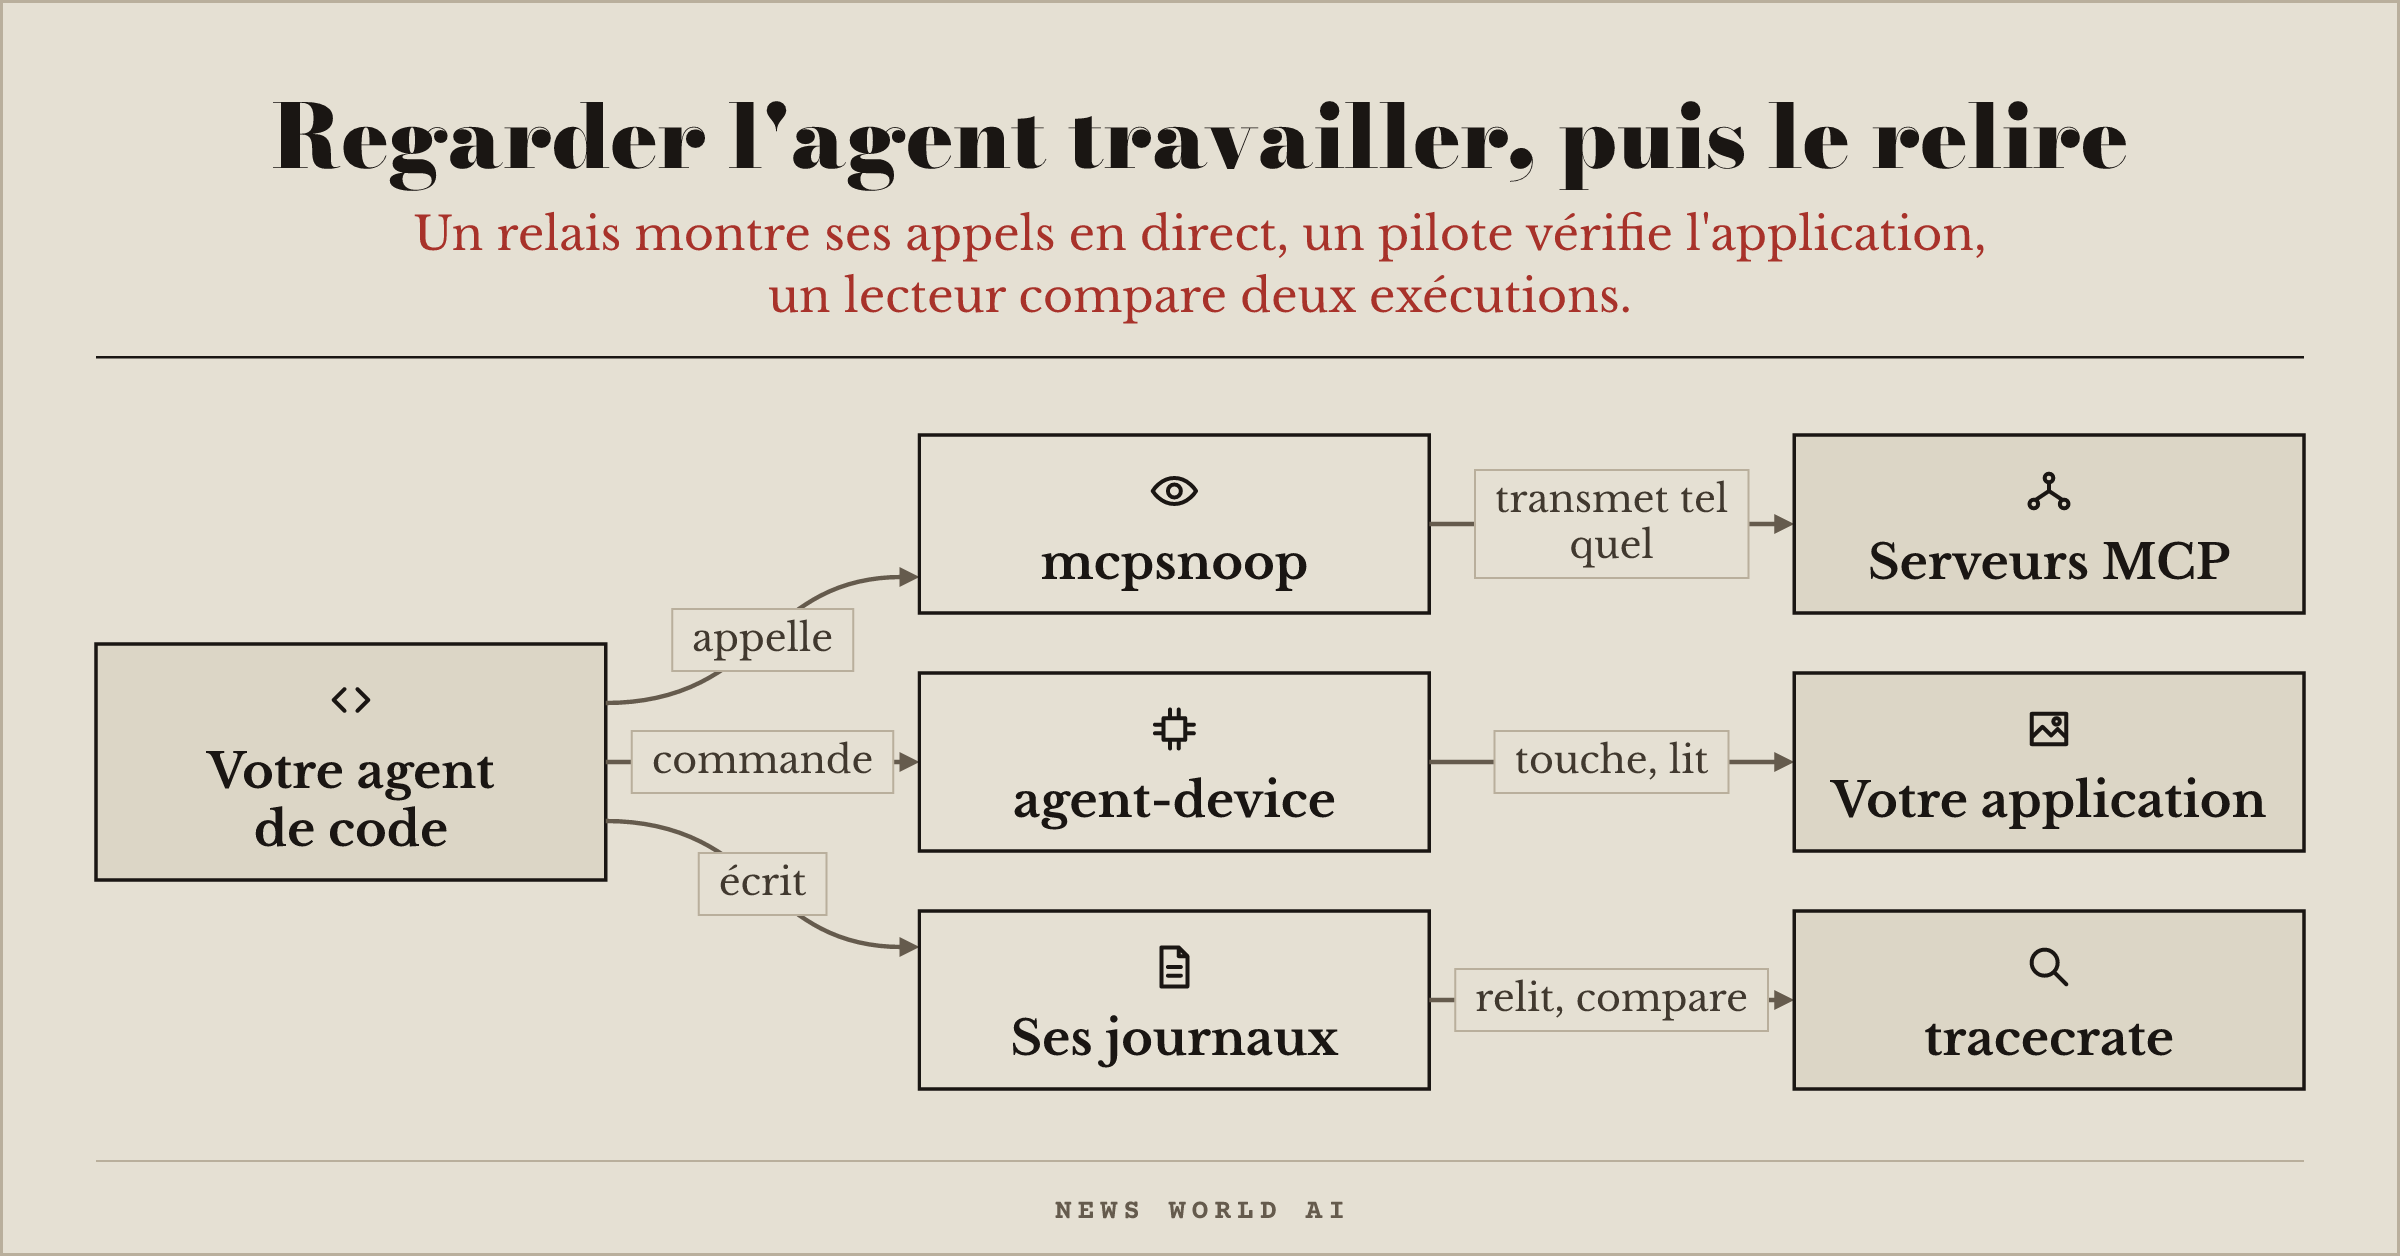
Votre agent de code peut piloter une application sur iOS, Android ou HarmonyOS (simulateur, émulateur ou vrai téléphone) : toucher l'écran, lire ce qui s'y affiche, vérifier le résultat. Chaque parcours s'enregistre dans un script que l'on peut rejouer pour tester. L'éditeur est Callstack, une société de services React Native. Ce qu'il ne fait pas : ne corrige pas de lui-même un script de rejeu devenu faux.
kerlenton/mcpsnoop · ★ 349 · MIT · dernier commit 11 septembre 2026
Se glisse entre votre assistant (Cursor, Claude Code, Codex) et ses serveurs MCP, les connecteurs qui lui donnent accès à vos outils, et montre en direct chaque appel d'outil réellement envoyé. Les échanges sont gardés sur le disque, et la version du 11 septembre ajoute des compteurs par outil, lisibles par l'outil de surveillance Prometheus. Ce qu'il ne fait pas : ne bloque ni ne modifie aucun appel.
FankChen/tracecrate · ★ 123 · MIT · dernier commit 13 septembre 2026
Lit les journaux de Claude Code et de Codex, ainsi que les traces au format OTLP (le standard d'échange de traces d'OpenTelemetry), compare deux exécutions et exporte un rapport expurgé. Aucun serveur, aucun compte, aucune clé : il tourne dans votre navigateur. Ce qu'il ne fait pas : ne lit aucun autre format (ni protobuf, ni collecteur en direct, ni transcription MCP), ne garantit pas l'anonymat du rapport.
Numéro 003 · ce que votre agent envoie sans le dire
okf-memory/okf-agent-memory · ★ 552 · MIT · dernier commit 9 septembre 2026
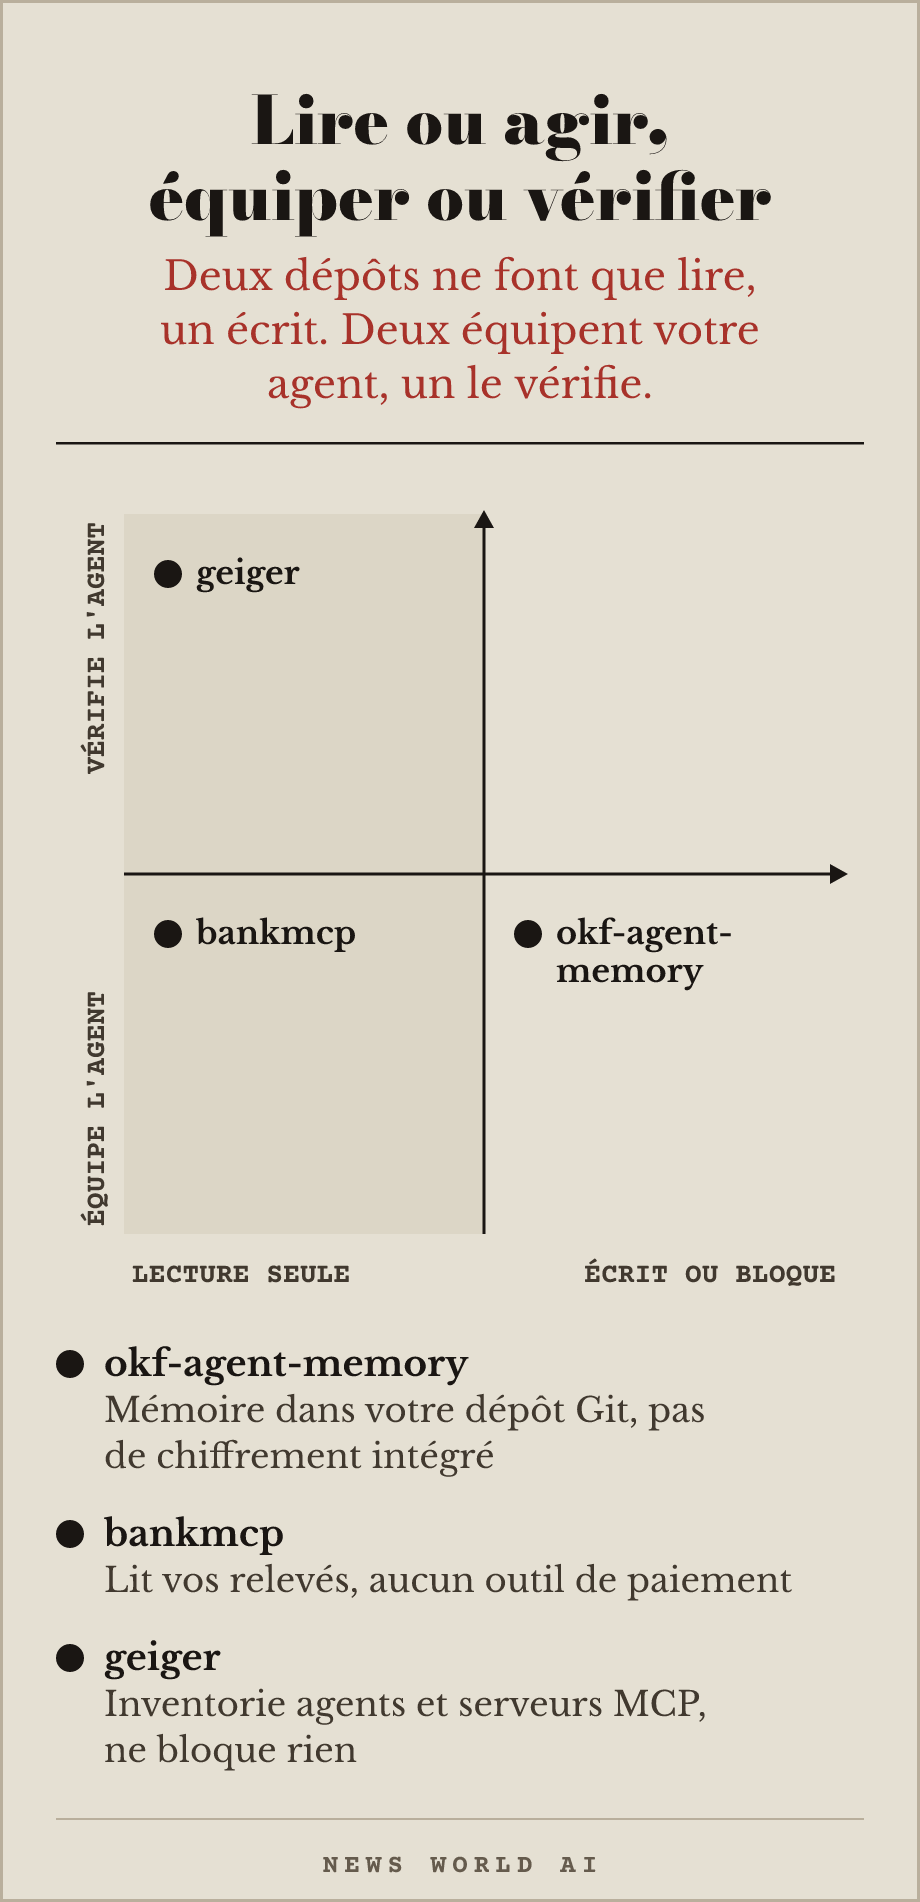
Mémoire persistante pour agents de code, rangée dans votre dépôt Git sous forme de fichiers texte. Annonce une recherche en moins de 300 microsecondes, embarque un serveur MCP, et annonce 80 % de jetons en moins dans son propre banc d'essai. Ce qu'il ne fait pas : pas de chiffrement intégré (tout est en texte clair), pas de gestion des conflits quand deux agents écrivent en même temps, pas encore de mémoire partagée à distance.
noskillish/bankmcp · ★ 178 · MIT · dernier commit 8 septembre 2026
Serveur MCP auto-hébergé et en lecture seule pour interroger vos propres comptes bancaires via l'open banking (les normes européennes qui permettent à un logiciel autorisé de consulter vos comptes), par l'intermédiaire d'Enable Banking. Testé avec Claude et Claude Code, et à titre expérimental avec des modèles locaux via Ollama. Votre agent peut lire vos relevés : le serveur n'a aucun outil de paiement. Ce qu'il ne fait pas : aucun paiement, aucune banque hors du réseau d'Enable Banking, un seul utilisateur par serveur, pas de version hébergée.
Atomburstofficial/geiger · ★ 106 · MIT · dernier commit 10 septembre 2026
Une commande en lecture seule qui inventorie les agents IA, serveurs MCP, extensions et branchements trouvés aux emplacements de configuration connus. Elle répond à une question que la plupart des gens ne savent pas trancher : qu'est-ce qui tourne sur cette machine, et à quoi a-t-il accès ? Ce qu'il ne fait pas : ne surveille pas en continu, ne bloque rien, ne dit pas ce qu'un agent a réellement fait.
Numéro 002 · Une chaîne d'info sans journaliste
msitarzewski/agency-agents · ★ 150 281 · MIT · dernier commit 5 septembre 2026
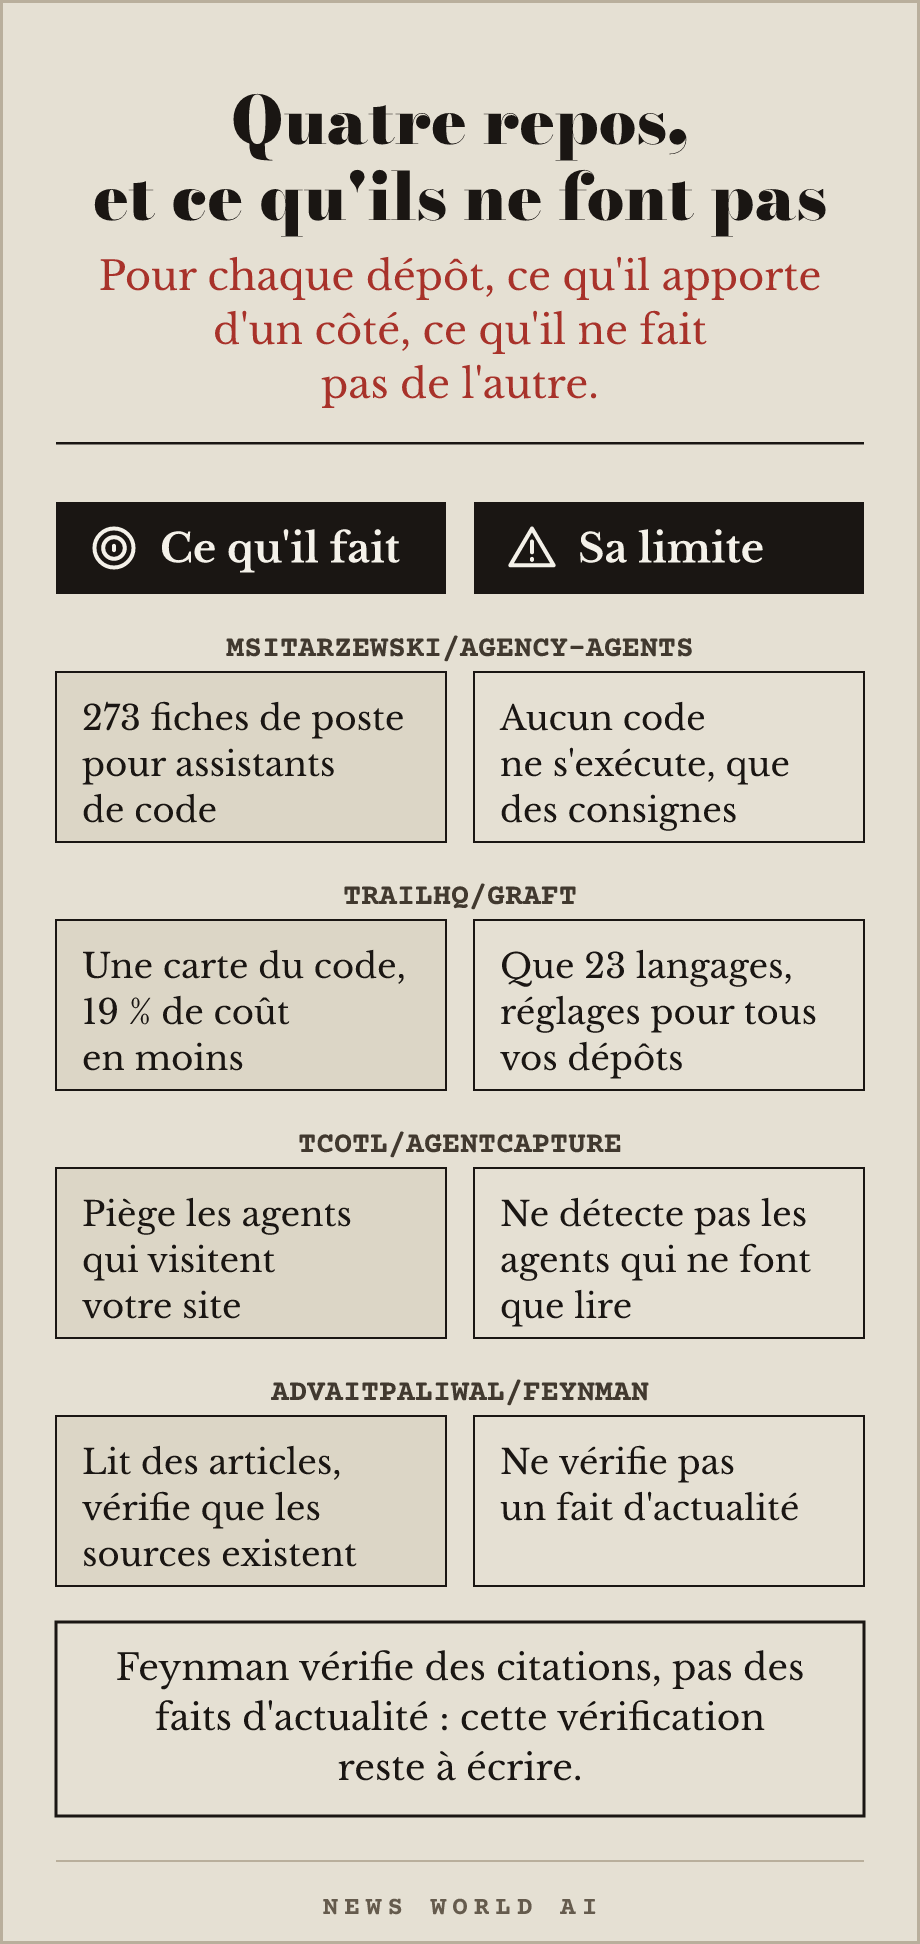
Une bibliothèque de fiches de poste pour assistants de code. Chaque fiche est un fichier texte qui décrit un spécialiste (sécurité, tests, référencement, finance) et que vous déposez dans votre outil. Le dépôt annonce plus de 230 agents. Notre propre comptage après clonage, le 6 septembre 2026, donne 273 fiches. Ce qu'il ne fait pas : aucun code ne s'exécute, ce ne sont que des consignes écrites. Le coût reste celui du modèle qui les lit. Le projet documente lui-même que certains outils n'en enregistrent qu'une partie et abandonnent le reste en silence.
trailhq/Graft · ★ 5 609 · MIT · dernier commit 2 septembre 2026
Il dresse la carte de votre code, en texte, et la donne à votre assistant de programmation pour qu'il cesse de relire tout le dépôt à chaque question. Son protocole standard (SWE-bench Verified, 50 cas, modèle identique des deux côtés) donne 19 % de coût en moins et 12 points de justesse en plus. Ce qu'il ne fait pas : il ne comprend que 23 langages et ignore le reste, et il n'installe rien pour le seul dépôt courant sans qu'on le lui demande. Les résumés en langage courant demandent une clé d'API et coûtent de l'argent, seule la carte structurelle est gratuite. Sa commande d'installation écrit des réglages pour tous vos dépôts, sauf à passer --no-global.
Tcotl/AgentCapture · ★ 35 · AGPL-3.0 · dernier commit 4 septembre 2026
Un pot de miel pour agents : 23 techniques pour identifier un agent qui visite votre site, le piéger, et rejouer sa session. Testé sur cinq agents grand public, tous piégés. Ce qu'il ne fait pas : ne détecte pas les agents qui se contentent de lire sans interagir. Ne bloque rien non plus, il observe et enregistre, la décision reste la vôtre.
advaitpaliwal/feynman · ★ 8 871 · MIT · dernier commit 6 septembre 2026
Un assistant en ligne de commande qui va chercher des articles scientifiques (arXiv, PubMed, OpenAlex, ClinicalTrials.gov), les lit, les classe, en tire une synthèse, et vérifie que chaque source citée existe vraiment. Ce qu'il ne fait pas : son terrain est la littérature scientifique, pas l'actualité. Il ne vérifie pas une affirmation journalistique. Il faut brancher son propre modèle, et faire tourner les expériences lourdes demande d'installer soi-même Docker, Modal ou RunPod.
Numéro 000 · Votre agent réussit une fois sur trois
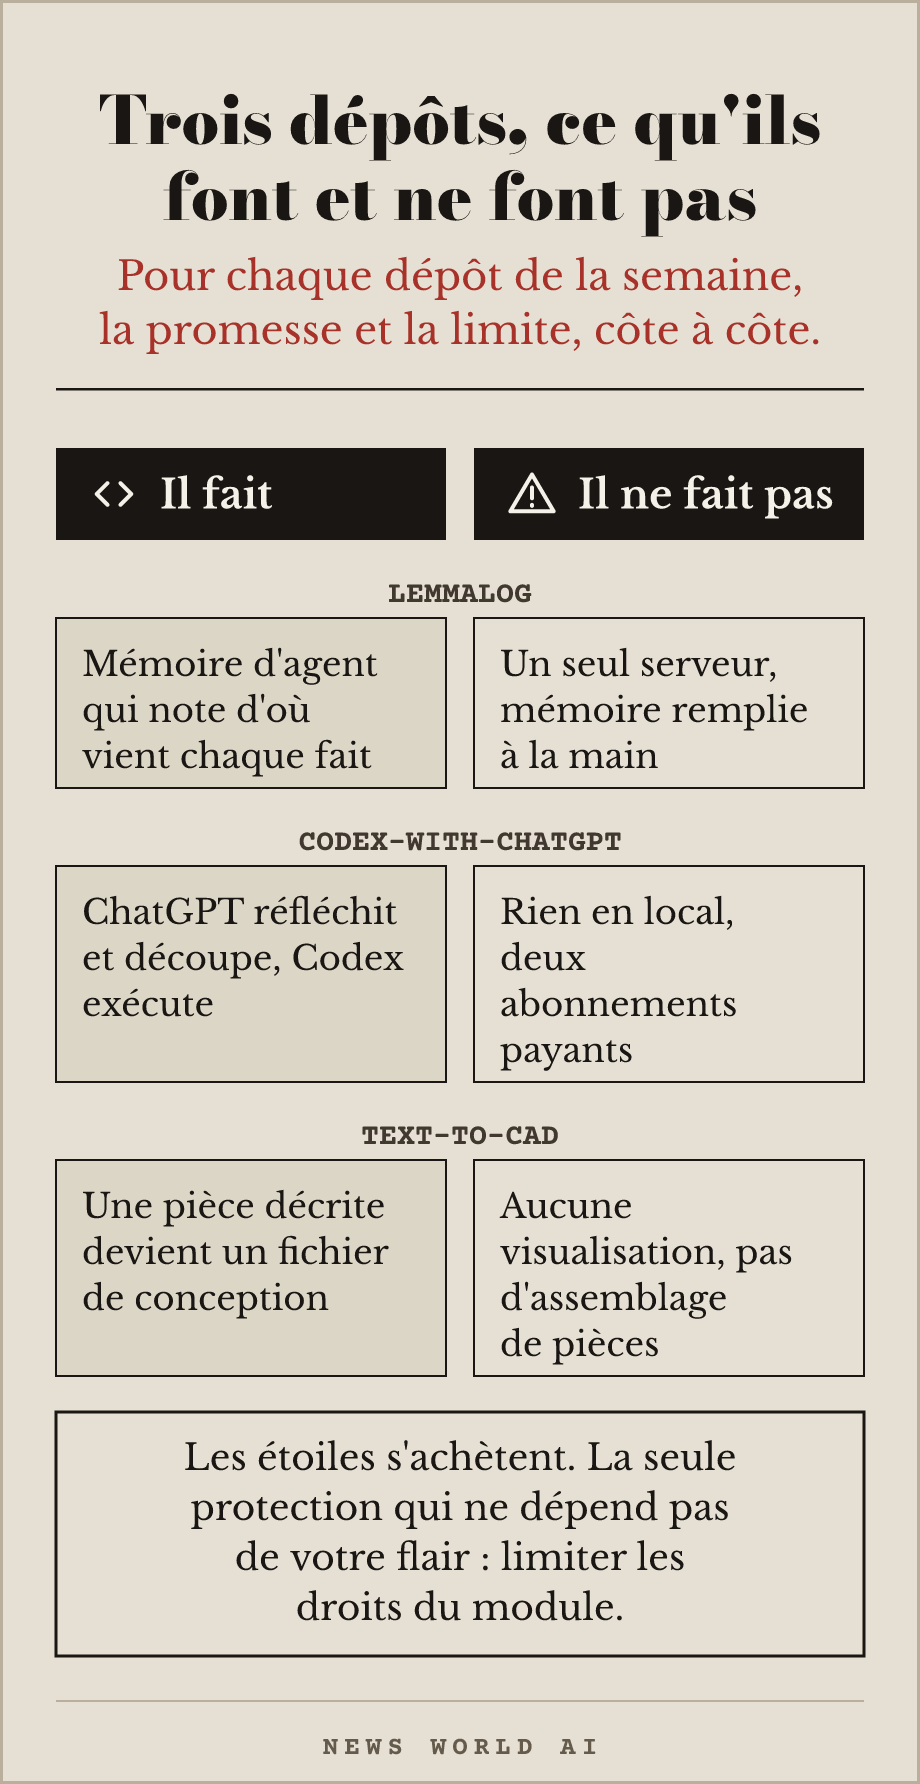
JordyZomer/lemmalog — 242 étoiles, licence MIT, dernier commit le 27 août 2026 Une mémoire pour agents qui garde la trace d'où vient chaque fait. Serveur MCP inclus, donc branchable directement sur votre agent.
Ce qu'il ne fait pas un seul serveur, aucune répartition, et la mémoire se remplit à la main : rien n'est extrait tout seul des conversations.
Peu d'étoiles, projet jeune : c'est normal et ça ne dit rien de sa qualité. Le risque ici n'est pas le piège, c'est l'abandon dans trois mois.
→ github.com/JordyZomer/lemmalog
XiaoDuoYa/codex-with-chatgpt — 2 072 étoiles, licence MIT, dernier commit le 28 août 2026 ChatGPT réfléchit et découpe la tâche, Codex exécute.
Ce qu'il ne fait pas rien en local, et il dépend de deux abonnements payants. Si l'un des deux fournisseurs ferme le robinet, le montage s'arrête, et cela arrive.
→ github.com/XiaoDuoYa/codex-with-chatgpt
earthtojake/text-to-cad — 14 101 étoiles, licence MIT, dernier commit le 1er septembre 2026 Décrire une pièce en français, récupérer le fichier de conception assistée par ordinateur.
Ce qu'il ne fait pas aucune visualisation, il faut un logiciel externe pour ouvrir le résultat, et il ne gère pas les assemblages de plusieurs pièces.
→ github.com/earthtojake/text-to-cad
Un avertissement qui vaut pour toute la rubrique. Les étoiles s'achètent, quelques centimes pièce. Un projet à cinquante mille étoiles avec douze copies et aucune discussion, cela n'arrive pas naturellement. Aucun de ces tests ne prouve rien, ils disent seulement où regarder. La seule protection qui ne dépende pas de votre flair, c'est de limiter ce que le module a le droit de faire.
Les archives reproduisent chaque numéro tel qu'il est parti, sans le réécrire. Les étoiles d'un dépôt, les prix et les dates de dernier commit sont ceux du jour de la vérification, pas ceux d'aujourd'hui : suivez le lien pour l'état courant.
Genève, Suisse. Écrire à hello@newsworldai.xyz.