News World
Les sorties
Les sorties
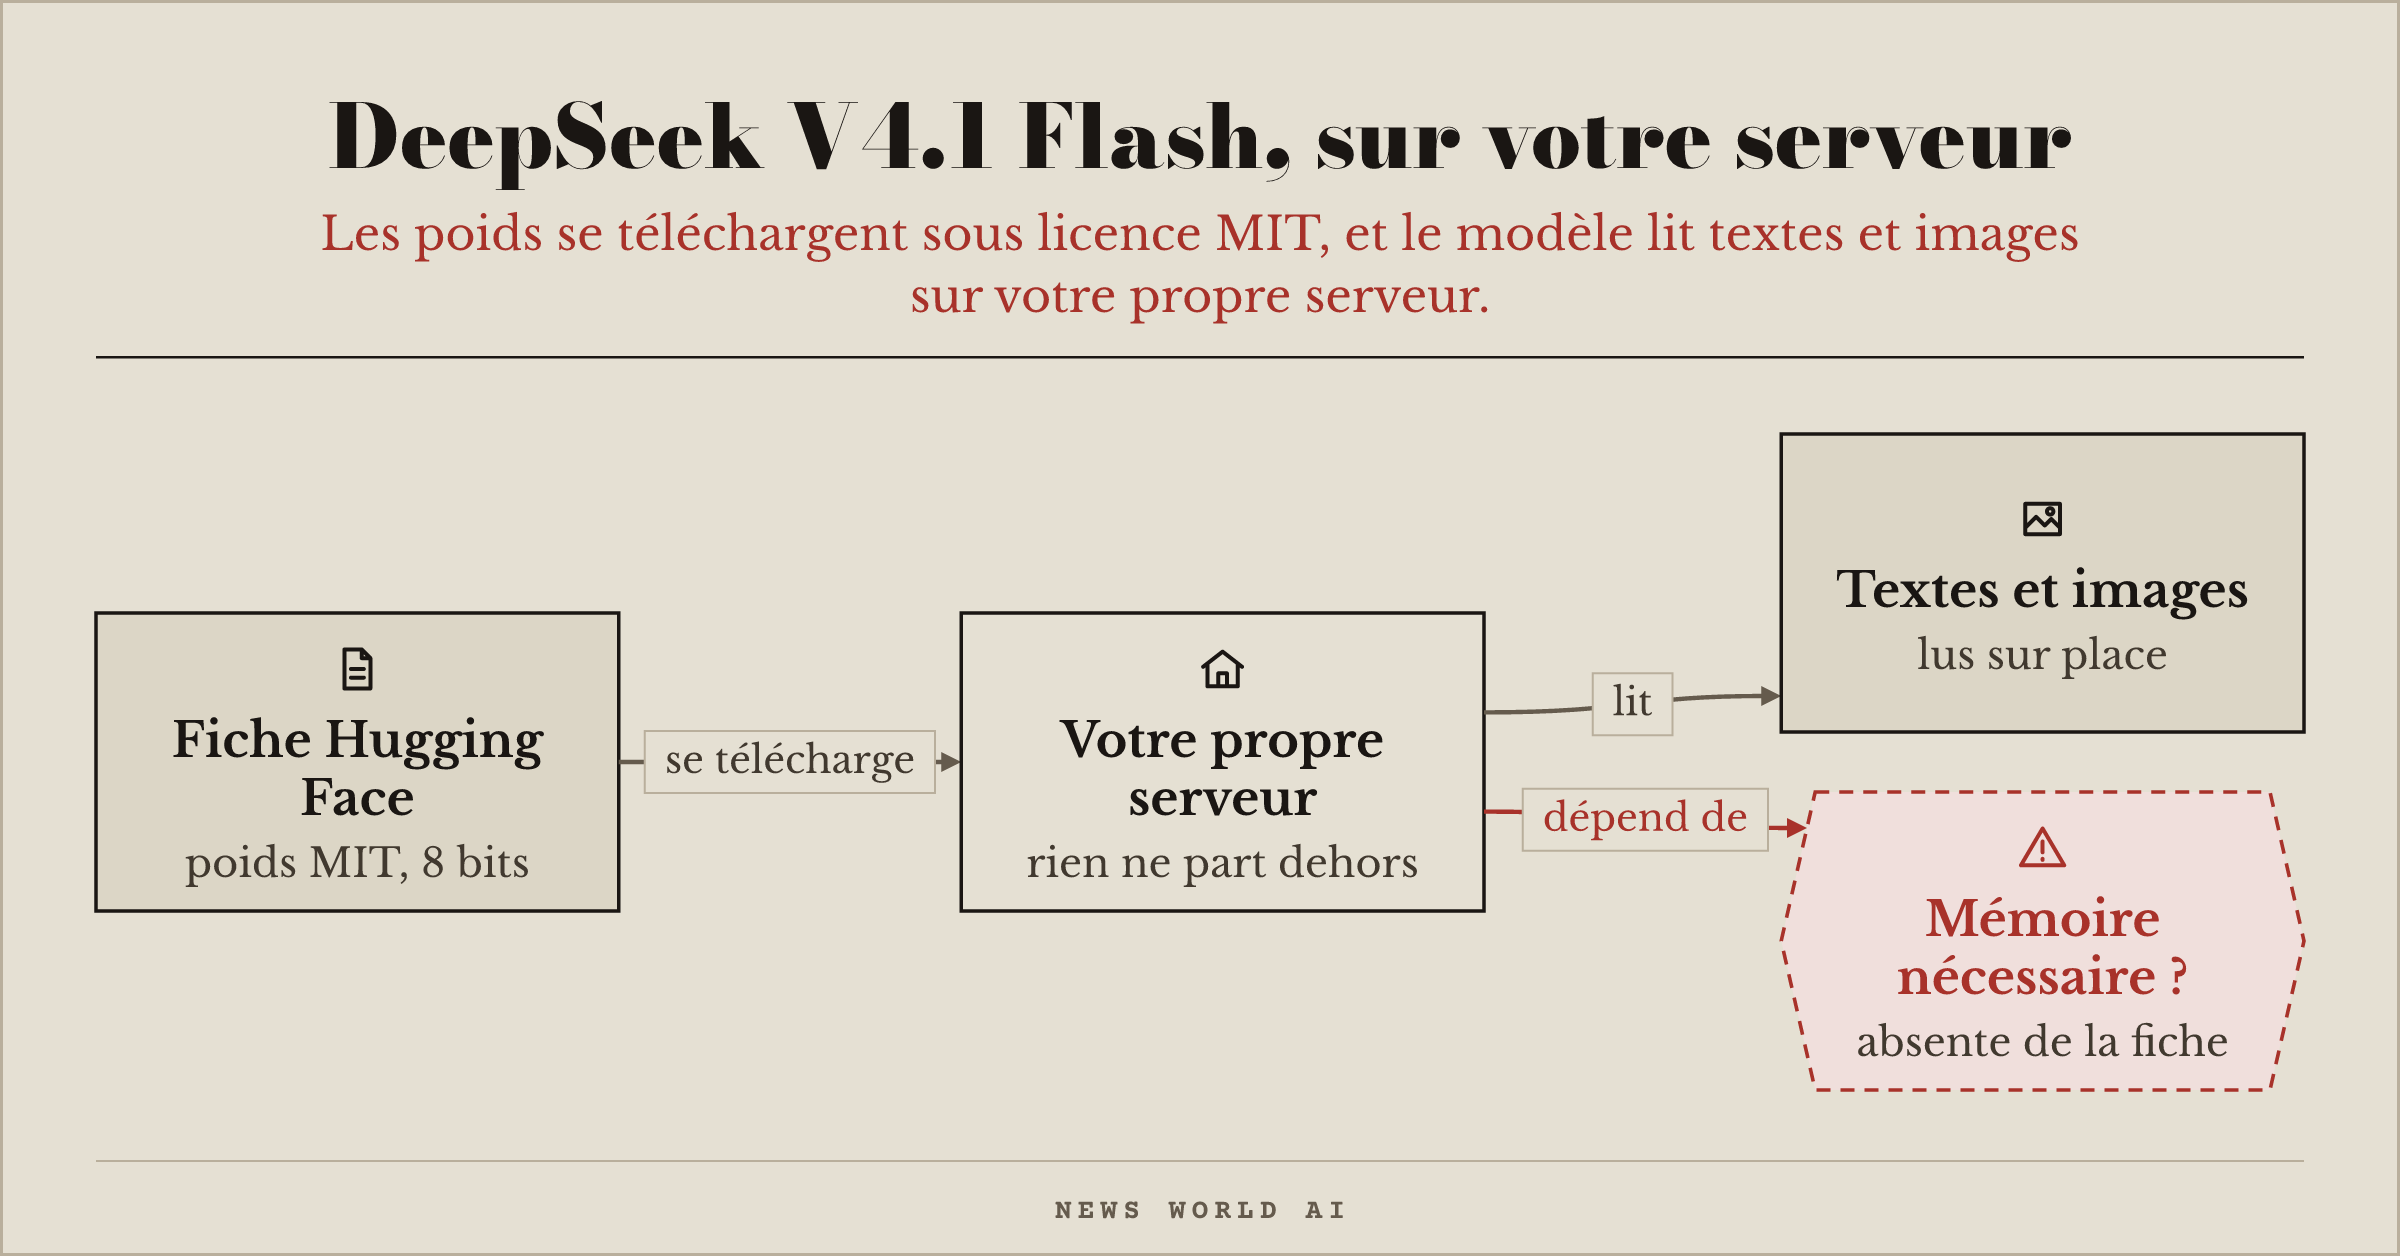
DeepSeek V4.1 Flash 1017 (DeepSeek)
27 737 téléchargements, 1 876 mentions j'aime sur Hugging Face. Licence MIT.
Pour quoi faire Faire tourner sur votre propre serveur un modèle rapide de 763 milliards de paramètres qui lit aussi les images, sans rien envoyer à DeepSeek. Les poids (le fichier du modèle) se téléchargent en version allégée sur 8 bits, selon leurs étiquettes, et la licence MIT ne vous impose presque rien. DeepSeek la présente comme une mise à jour mineure de la version du 004 : raisonnement, code, tâches d'agent et images progressent (42,6 contre 36,8 au test HLE sans outils). Mise en ligne le 17 octobre sur Hugging Face, elle sort la semaine où un ordre du ministère américain de la Sécurité intérieure, publié le 20 octobre au Federal Register, retire des agences fédérales civiles les produits DeepSeek et les produits d'autres éditeurs construits avec sa technologie.
Limite La fiche n'indique pas la mémoire nécessaire, et ne propose pas de version plus petite.
LFM2.5-24B-A2B (Liquid AI)
Billet de Liquid AI : 288 points et 81 commentaires sur Hacker News. Version GGUF (le format que lisent llama.cpp, LM Studio et Ollama) : 132 848 téléchargements sur Hugging Face.
Pour quoi faire Faire tourner un agent rapide sur votre propre appareil, sans carte graphique de centre de données. Le modèle compte 24 milliards de paramètres (les réglages qu'il a appris), mais 2 milliards seulement travaillent à chaque mot : il ne réveille à chaque fois que quelques spécialistes parmi les siens (on parle de mélange d'experts). Au 007, Liquid AI publiait d1, ses modèles de décision pour appareils : le laboratoire garde la même ligne, l'appareil d'abord.
Limite Bancs d'essai et vitesses de l'éditeur seulement, aucune mesure indépendante. Pas de licence standard : une licence propre aux modèles LFM, dont le billet ne résume pas les conditions commerciales.
Nemotron 3.5 Super VL (NVIDIA)
11 459 téléchargements, 186 mentions j'aime pour la version NVFP4 sur Hugging Face.
Pour quoi faire Confier à un agent des tâches qui mêlent texte, images et vidéo : comprendre un document, chercher, se servir d'outils, coder. C'est un modèle ouvert de 120 milliards de paramètres, dont 12 milliards au travail à chaque mot. Ses poids sont publiés notamment au format NVFP4, une version allégée sur 4 bits, sous licence OpenMDW 1.1 qui permet l'usage commercial.
Limite La fiche n'indique ni prise en charge du Mac (Linux seulement) ni mémoire totale nécessaire.
Sphinx
Sur Hacker News : 252 points, 89 commentaires.
Pour quoi faire Ne livrer que le code que vous avez compris. Avant d'envoyer ce que votre IA a écrit, un crochet (un petit contrôle qui se déclenche à ce moment-là) vous pose des questions sur ce code. Au 008, notre crochet refusait un changement ; Sphinx interroge la personne.
Limite Sphinx n'a pas de service à lui : le code modifié part chez le fournisseur du modèle relecteur que vous choisissez (les fichiers .env et les clés en sont exclus).
Llmspeed
Sur Hacker News : 329 points, 86 commentaires.
Pour quoi faire Sentir, avant d'acheter une machine, à quelle vitesse un modèle local y répondrait. Utile la semaine où les portables RTX Spark arrivent en magasin (voir En bref).
Limite Ce ne sont pas des mesures faites par le site : une partie vient de bancs d'essai communautaires, le reste est extrapolé ; rien sur la qualité des réponses.
Exa 3.0
Annoncé par Exa le 19 octobre.
Pour quoi faire Donner à votre agent un moteur de recherche fait pour lui, qui lui sert les passages utiles des pages. Exa promet dans cette version des données plus riches, sans surcoût, et une formule Lite moins chère. Utile quand les sites ferment leurs portes aux agents (voir À lire).
Limite Les promesses sont celles de l'éditeur, sans banc indépendant. Pas de version à héberger chez vous : chaque requête passe par l'API d'Exa.
Recevoir la newsletter
Chaque mardi, en quatre minutes : ce qui est sorti dans l'IA et qu'on peut essayer le jour même.
Double confirmation par courriel. Désabonnement en un clic, lien visible en clair dans chaque envoi.
Genève, Suisse. Écrire à hello@newsworldai.xyz.